
O RNA-seq complementa e, em muitos casos, resolve lacunas do DNA-seq: é a escolha quando se procura detetar splicing aberrante, isoformas patológicas ou assinaturas transcriptómicas específicas de doenças raras. O DNA-seq mostra a variante; o RNA-seq mostra o que essa variante faz à célula. A técnica certa (bulk, unicelular, long-read ou espacial) depende da pergunta biológica e do tecido disponível, mas nenhum resultado deve orientar decisões terapêuticas sem validação funcional posterior.
Em resumo:
- O RNA-seq é fundamental para detectar splicing aberrante, isoformas patológicas e assinaturas específicas de doenças raras, complementando o DNA-seq.
- A escolha da tecnologia depende da heterogeneidade celular, sendo o bulk adequado para sinais consistentes e o scRNA para identificar subpopulações raras.
- Modelos de células derivadas de pacientes, como iPSC e organoides, são essenciais quando o tecido relevante não é acessível ou expressa poucos genes de interesse.
- A validação funcional de variantes de splicing requer RT-PCR ou ensaios de minigene, preferencialmente com linhas de células corrigidas por CRISPR para evidência causal.
- A integração de diferentes abordagens transcriptómicas, com protocolos bem documentados, melhora o diagnóstico em doenças raras, embora a falta de referências populacionais limite a adoção clínica.
Índice
- Bulk RNA-seq, scRNA-seq, long-read ou espacial: qual escolher?
- Que modelos experimentais geram amostras úteis para RNA-seq?
- Como transformar dados brutos de RNA-seq em interpretação clínica
- Como validar funcionalmente uma variante de splicing?
- Integrar bulk, unicelular e espacial: quando compensa o esforço
- RNA-seq melhora mesmo o diagnóstico de doenças raras?
- Como um laboratório translacional aplica RNA-seq na prática
- Onde aprofundar: leituras e recursos primários
- O que falta para o RNA-seq se tornar rotina no diagnóstico raro
- Fontes
- Perguntas frequentes
Bulk RNA-seq, scRNA-seq, long-read ou espacial: qual escolher?
A pergunta que determina a escolha nunca é "qual a tecnologia mais avançada", mas sim "que tipo de heterogeneidade preciso de capturar". Um bulk RNA-seq mede a média de expressão de milhões de células misturadas. Isso basta quando se procura um sinal consistente numa coorte, como uma isoforma anómala presente em todas as células de um tecido afetado. Já quando a doença envolve subpopulações celulares raras (uma linhagem de neurónios específica, um subconjunto de células imunes disfuncionais), o bulk dilui o sinal até ele desaparecer no ruído médio.
O RNA-seq unicelular resolve essa heterogeneidade, mas custa mais por amostra, exige mais células viáveis à entrada e produz dados com maior ruído técnico, o que obriga a compromissos práticos entre profundidade de sequenciação e número de células capturadas, segundo uma revisão metodológica sobre transcriptómica. O long-read RNA-seq (PacBio, Oxford Nanopore) resolve isoformas completas, algo que o short-read tradicional infere por reconstrução e frequentemente erra em genes com muitos exões alternativos. O RNA-seq espacial acrescenta a coordenada que falta a todos os anteriores: onde, dentro do tecido, o sinal transcriptómico ocorre.
Os critérios práticos de escolha resumem-se a isto:
- Bulk RNA-seq: coortes maiores, orçamento limitado, tecido homogéneo, pergunta sobre expressão global ou splicing dominante.
- scRNA-seq: heterogeneidade celular suspeita, doenças com subpopulações afetadas de forma desigual, necessidade de atribuir sinal a um tipo celular.
- Long-read RNA-seq: genes com isoformas complexas, suspeita de eventos de splicing não anotados, validação de transcritos completos.
- RNA-seq espacial: doenças com componente arquitetural, como neuro degeneração com padrões de perda celular localizados.
Uma revisão de 2024 sobre RNA-seq no diagnóstico de doenças descreve a utilidade crescente destas quatro abordagens combinadas, sublinhando que a decisão certa raramente é uma tecnologia isolada, mas uma sequência: começar por bulk ou short-read para triagem, avançar para scRNA ou long-read quando o sinal exige resolução adicional.
Dica profissional: Antes de gastar orçamento em scRNA-seq, corra um bulk RNA-seq exploratório. Se o sinal já for claro em bulk, o unicelular raramente traz informação nova suficiente para justificar o custo adicional.
Que modelos experimentais geram amostras úteis para RNA-seq?
A primeira pergunta nunca é "que tecnologia de sequenciação", mas "tenho acesso ao tecido certo". Muitas doenças raras afetam órgãos inacessíveis à biópsia, como o cérebro ou o coração fetal, o que obriga a escolher entre amostras clínicas indiretas e modelos celulares derivados do próprio paciente.
Sangue, fibroblastos de pele e, ocasionalmente, biópsias de músculo são os tecidos clínicos mais acessíveis. O problema é que muitos genes causadores de doença têm expressão tecido-específica: um gene relevante para uma miopatia pode estar silencioso em fibroblastos, tornando o RNA-seq desse tecido inconclusivo mesmo com a variante patogénica confirmada por DNA-seq.
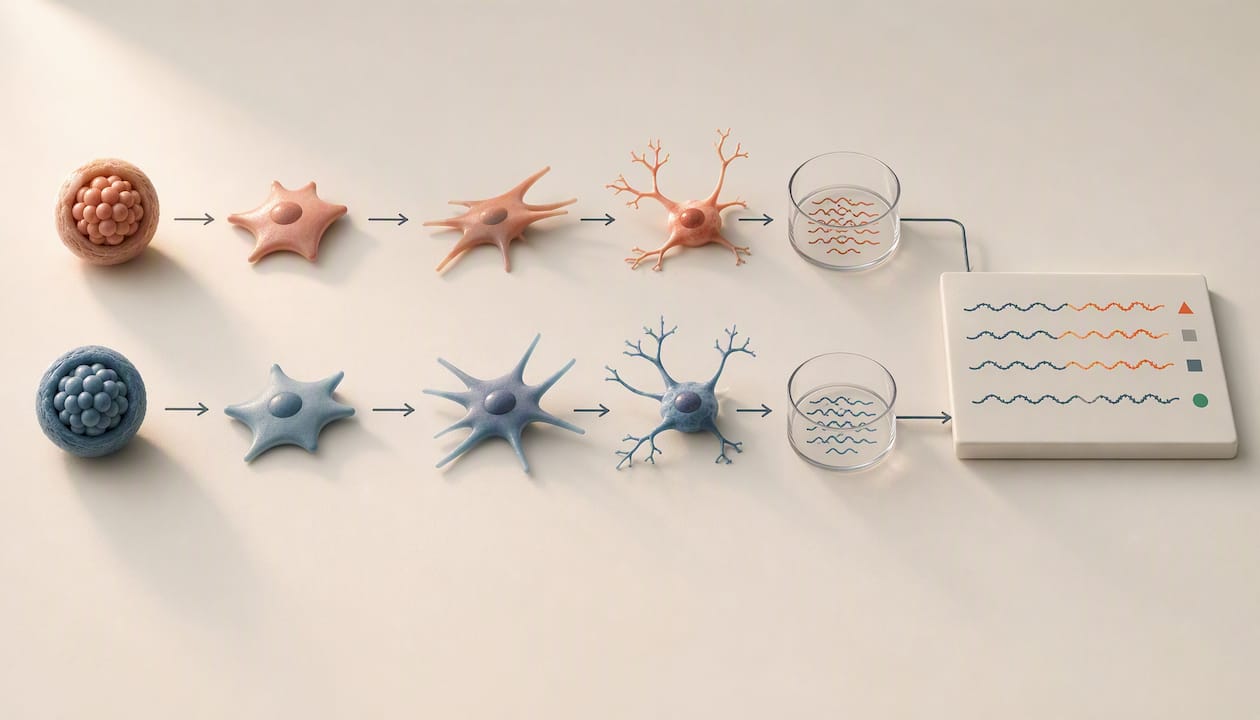
Quando o tecido relevante não é acessível, a alternativa passa por derivar células estaminais pluripotentes induzidas (iPSC) do próprio paciente e diferenciá-las no tipo celular de interesse, ou avançar para organoides tridimensionais que reproduzem interações intercelulares. Um estudo sobre modelos de Parkinson ligado ao gene PRKN mostrou que passar de neurónios iPSC em 2D para organoides tridimensionais melhora significativamente a captura de assinaturas transcriptómicas pré-sintomáticas, algo essencial para estudar doenças progressivas antes do aparecimento de sintomas clínicos.
Um pipeline típico de iPSC até RNA-seq segue esta sequência:
- Reprogramação de fibroblastos ou células mononucleares do sangue periférico em iPSC (semanas a meses, dependendo da eficiência da linha).
- Validação de pluripotência e cariótipo normal antes de avançar.
- Diferenciação dirigida para o tipo celular relevante (protocolos variam de duas a doze semanas segundo a linhagem).
- Extração de RNA e controlo de qualidade antes da sequenciação.
- Comparação com uma linha isogénica corrigida por CRISPR, sempre que possível, para isolar o efeito da variante do ruído genético de fundo.
O uso de coculturas multiplexadas e desenho experimental com controlos isogénicos ajuda a mitigar os efeitos de lote (batch effects) que, de outra forma, confundem-se facilmente com o efeito biológico real da variante em estudo. Para um guia técnico completo sobre derivação e diferenciação, vale consultar este guia sobre modelos iPSC derivados de pacientes.
Dica profissional: Corra sempre a linha isogénica corrigida em paralelo com a linha do paciente, na mesma ronda de diferenciação. Comparar lotes diferentes introduz variabilidade técnica que pode ser confundida com sinal biológico.
Como transformar dados brutos de RNA-seq em interpretação clínica
O caminho do ficheiro FASTQ até uma decisão clínica passa por decisões técnicas concretas, cada uma com consequências diretas na fiabilidade do resultado final. O controlo de qualidade inicial (FastQC, MultiQC) filtra leituras de baixa qualidade e deteta contaminação antes de qualquer alinhamento. Segue-se o trimming de adaptadores e o alinhamento propriamente dito: STAR ou HISAT2 para short-read, minimap2 para long-read.
A quantificação pode ocorrer ao nível do gene ou do transcrito. Ferramentas como Salmon e Kallisto fazem quantificação rápida ao nível do transcrito sem alinhamento completo, o que é útil quando o interesse está em isoformas específicas e não apenas em expressão génica agregada. A normalização (TPM, DESeq2, Edgar) corrige diferenças de profundidade de sequenciação entre amostras antes de qualquer comparação estatística ter validade.
A deteção de splicing aberrante exige ferramentas dedicadas. O LeafCutter identifica eventos de splicing diferencial através de clusters de junções de splicing sem depender de anotações genómicas completas, o que o torna útil para encontrar eventos não catalogados. O MAJIQ quantifica variação local de splicing (LSD) e é particularmente sensível a eventos complexos com múltiplos exões alternativos. Para prever o efeito de uma variante candidata antes mesmo de a validar experimentalmente, o SpliceAI e o Pangolin usam redes neuronais treinadas em sequências genómicas para estimar a probabilidade de alteração de splicing.
A análise de expressão alélica específica (ASE) compara a expressão do alelo materno e paterno numa amostra heterozigótica, revelando silenciamento alélico ou efeitos cis-reguladores que o DNA-seq nunca detetaria isoladamente. Exige um genoma de referência bem anotado e, idealmente, dados de genotipagem parental para atribuir corretamente cada leitura ao alelo de origem.
Critérios estatísticos rigorosos para identificar outliers transcriptómicos (métodos como OUTRIDER) evitam que um único evento tecnicamente aberrante seja confundido com um achado clinicamente relevante.
Uma revisão sobre bioinformática de transcritómica observa que scRNA e bulk RNA-seq partilham muitas ferramentas de análise diferencial, mas o ruído técnico do scRNA obriga a ajustes estatísticos que o bulk raramente exige, tornando a escolha do pipeline tão importante como a escolha da tecnologia de sequenciação.
Documentar e partilhar o pipeline (via Snakemake, Nextflow, ou contentores Docker/Singularity com versões fixas de cada ferramenta) não é burocracia acessória. É a diferença entre um resultado reprodutível e um achado que ninguém, incluindo o próprio laboratório seis meses depois, consegue confirmar. Registos como Zenodo ou repositórios institucionais de workflows garantem que a análise sobrevive à rotação de pessoal.
- Controlo de qualidade e trimming antes de qualquer alinhamento.
- Alinhamento com STAR/HISAT2 (short-read) ou minimap2 (long-read).
- Quantificação ao nível do transcrito quando isoformas importam.
- Deteção de splicing com LeafCutter ou MAJIQ, previsão com SpliceAI ou Pangolin.
- Documentação do pipeline em Nextflow, Snakemake ou contentores versionados.
Como validar funcionalmente uma variante de splicing?
Encontrar um evento de splicing aberrante por RNA-seq é uma hipótese, não uma prova. A causalidade só se estabelece com validação funcional dirigida, e aqui a escolha do método depende quase sempre de uma limitação prática: o tecido do paciente está disponível ou não.
Quando existe RNA do paciente com expressão suficiente do gene de interesse, a RT-PCR seguida de sequenciação do produto amplificado confirma diretamente se a variante altera o padrão de splicing observado, comparando com um controlo saudável. É o método mais direto e mais convincente clinicamente.
Quando o tecido relevante é inacessível (um gene expresso apenas no sistema nervoso central, por exemplo), o ensaio de minigene torna-se a alternativa estabelecida. Um protocolo de referência sobre ensaios repórter de splicing descreve o uso de vetores como pSpliceExpress para clonar a região genómica de interesse, incluindo a variante candidata, e observar o padrão de splicing resultante num contexto celular controlado. Este processo segue geralmente esta sequência:
- Clonagem da região genómica com e sem a variante candidata num vetor repórter (aproximadamente uma semana para a construção inicial do plasmideo).
- Transfeção em linhas celulares apropriadas (HEK293 é comum, mas nem sempre representativa do tecido de origem).
- Extração de RNA e RT-PCR do transcrito do minigene entre 24 e 48 horas após transfeção.
- Sequenciação do produto para confirmar inclusão, exclusão ou uso de junção de splicing críptica.
Protocolos mais recentes combinam minigene com sequenciação long-read para resolver isoformas completas geradas pelo ensaio, um refinamento útil quando o efeito da variante gera múltiplos produtos de splicing simultâneos.
Para estabelecer causalidade num contexto celular fisiologicamente relevante, linhas de iPSC isogénicas corrigidas por CRISPR oferecem a evidência mais forte: comparar a linha do paciente com uma linha geneticamente idêntica exceto na variante em estudo isola o efeito causal de qualquer ruído genético de fundo. Consultar este guia prático sobre CRISPR na modelação de doenças raras ajuda a desenhar corretamente essas correções.
Dica profissional: Priorize para triagem de fármacos ou desenvolvimento de ASOs apenas variantes já validadas funcionalmente. Testar terapêuticas sobre uma hipótese de splicing não confirmada desperdiça tempo e recursos que, em doenças raras, raramente sobram.
Integrar bulk, unicelular e espacial: quando compensa o esforço
Combinar tecnologias raramente é opcional quando a doença envolve múltiplos tipos celulares com contribuições distintas para o fenótipo. A integração de dados bulk e scRNA-seq segue três abordagens principais, cada uma com um custo computacional e um pressuposto biológico diferente.
A deconvolução baseada em referências usa um atlas de expressão de tipos celulares conhecidos para estimar a proporção de cada tipo celular presente numa amostra bulk, sem necessidade de sequenciar unicelular todas as amostras da coorte. A pseudobulk faz o caminho inverso: agrega dados scRNA por tipo celular para os tornar comparáveis com bulk RNA-seq de outras coortes. A modelagem conjunta bayesiana integra ambos os tipos de dados simultaneamente, propagando incerteza entre camadas em vez de tratar cada etapa como um passo isolado e definitivo.
Uma revisão sobre integração de dados transcriptómicos descreve estas estratégias e sublinha que a deconvolução baseada em referências permite inferir composição celular sem o custo de sequenciar unicelular cada amostra da coorte, desde que o atlas de referência seja representativo da população em estudo.
Construir um atlas scRNA interno tem sentido quando a doença envolve um tipo celular raro ou atípico que atlas públicos (como o Human Cell Atlas) simplesmente não capturam bem. Usar um atlas público mau representativo introduz erros de atribuição silenciosos, difíceis de detetar sem validação independente.
Aplicações práticas desta integração incluem:
- Atribuir um biomarcador identificado em bulk a um tipo celular específico, orientando desenho de terapêuticas dirigidas.
- Distinguir se uma alteração transcriptómica reflete mudança na proporção de tipos celulares ou reprogramação transicional dentro do mesmo tipo celular, duas explicações biológicas muito diferentes para o mesmo sinal de bulk.
- Cruzar assinaturas espaciais com dados de deconvolução para confirmar localização anatómica de um sinal molecular.
Documentar os pesos e pressupostos de cada método de deconvolução, e validar cruzadamente com um subconjunto de amostras sequenciadas em ambas as modalidades sempre que o orçamento permitir, evita conclusões que parecem robustas mas dependem inteiramente da qualidade do atlas de referência escolhido.
RNA-seq melhora mesmo o diagnóstico de doenças raras?
A evidência publicada aponta para sim, com números concretos. Estudos de caso e séries de coortes referidos numa revisão sobre RNA-seq no diagnóstico mostram que adicionar RNA-seq à investigação genómica padrão aumentou a taxa de diagnóstico de 31% para 38% em algumas séries de doenças raras sem diagnóstico após exoma ou genoma completo. Isto acontece precisamente porque variantes não codificantes, intrónicas profundas ou sinónimas (que o DNA-seq classifica como benignas ou de significado incerto) revelam o seu efeito patogénico apenas ao nível do transcrito.
Assinaturas transcriptómicas e padrões de splicing aberrante orientam também a priorização terapêutica. Um gene com splicing exão-skipping confirmado é candidato natural a um oligonucleotídeo antissenso (ASO) desenhado para corrigir esse evento específico; uma via de expressão desregulada pode apontar para um fármaco já aprovado com mecanismo de ação sobreponível, uma estratégia de reposicionamento terapêutico que reduz drasticamente o tempo até ao ensaio clínico comparado com desenvolvimento de novo.
As barreiras à adoção clínica rotineira permanecem reais. Faltam bancos de referência transcriptómica populacional tão robustos quanto os disponíveis para variantes de DNA (gnomAD tem equivalentes parciais, mas não completos, no espaço transcriptómico). A interpretação regulamentar de resultados de RNA-seq como evidência de patogenicidade ainda não tem enquadramento tão maduro quanto os critérios ACMG para DNA. E a normalização entre laboratórios, plataformas de sequenciação e protocolos de extração de RNA introduz variabilidade técnica que dificulta comparação direta de resultados entre centros.
Para centros de diagnóstico translacional que consideram adotar RNA-seq de forma sistemática, recomenda-se:
- Estabelecer controlos de referência internos sequenciados na mesma plataforma e protocolo, em vez de depender exclusivamente de bases de dados públicas heterogéneas.
- Reservar sempre orçamento e tempo para validação funcional (minigene ou RT-PCR) antes de comunicar um achado como causal a uma família ou médico.
- Considerar RNA-seq como complemento ao DNA-seq negativo ou inconclusivo, não como substituto de primeira linha, dado o custo e complexidade de interpretação superiores.
Como um laboratório translacional aplica RNA-seq na prática
Um pipeline translacional realista raramente começa pela sequenciação. Começa pela pergunta: este tecido, nesta forma, responde à questão biológica que o médico ou a família colocaram? Alguns laboratórios translacionais constroem modelos de doença específicos do paciente a partir de iPSC e edição genética CRISPR, com linhas isogénicas corrigidas para servir de controlo direto em cada comparação transcriptómica.
O fluxo típico segue esta lógica: derivação de iPSC a partir de células do paciente, diferenciação para o tecido relevante, RNA-seq comparativo entre a linha do paciente e a linha isogénica corrigida, deteção de splicing aberrante ou expressão alélica anómala, e validação funcional dirigida (RT-PCR ou minigene) antes de qualquer variante ser considerada causal. Só depois desse passo podem entrar etapas como a triagem paralela de fármacos aprovados, o desenho de ASOs customizados, ou a avaliação de estratégias de terapia génica.
Para investigadores e médicos que consideram contratar serviços translacionais deste tipo, as expectativas realistas incluem tempo de derivação e diferenciação de iPSC medido em semanas a meses, necessidade de amostra biológica viável do paciente, e outputs que exigem sempre revisão clínica antes de qualquer decisão terapêutica. Nenhum resultado de RNA-seq, por mais claro que pareça, substitui o julgamento do investigador-clínico responsável pelo caso, especialmente quando a via seguinte envolve preparação para uma reunião pré-IND com reguladores.
Onde aprofundar: leituras e recursos primários
Para quem quer ir além deste guia, os artigos e protocolos citados acima cobrem desde a evidência diagnóstica até aos detalhes técnicos de validação. Vale complementar com repositórios como o SRA (Sequence Read Archive) para dados brutos públicos, o GTEx para referências de expressão tecido-específica em população saudável, e atlas celulares públicos como o Human Cell Atlas para deconvolução. Para modelos experimentais, este guia sobre organoides como modelos de doença e este outro sobre modelos humanos versus animais complementam a discussão técnica.
O que falta para o RNA-seq se tornar rotina no diagnóstico raro
A tecnologia já não é o obstáculo. O obstáculo é a falta de referências populacionais transcriptómicas tão maduras quanto as que existem para DNA, e a escassez de fluxos de trabalho que tratem a validação funcional como etapa obrigatória em vez de extra opcional quando há tempo. Vejo demasiados grupos a tratar um evento de splicing detetado por RNA-seq como resultado final, quando devia ser apenas o ponto de partida para um ensaio de minigene ou uma linha isogénica.
A prioridade real para a próxima fase do campo não é mais poder computacional. É colaboração: bioinformáticos que entendam as limitações biológicas dos seus modelos estatísticos, clínicos que saibam que amostra pedir e quando, e laboratórios que tratem a validação como parte do pipeline, não como verificação posterior. Sem essa conjugação, o RNA-seq continuará a gerar hipóteses brilhantes que nunca chegam a tratamento.
— John
Este artigo fornece informações gerais e não substitui o aconselhamento de um médico qualificado. Consulte um profissional de saúde qualificado sobre o seu caso antes de agir com base neste conteúdo.
Fontes
- RNA Sequencing in Disease Diagnosis
- Integration of Bulk and Single-Cell RNA Sequencing Analyses in Biomedicine
- Dissecting the transcriptome of Parkin (PRKN)-linked Parkinson’s disease using 2D and 3D hiPSC-neuronal models
- Use of Splicing Reporter Minigene Assay to Evaluate the Effect on Splicing of Unclassified Genetic Variants
- Bioinformatics perspectives on transcriptomics: A comprehensive review of bulk and single‐cell RNA sequencing analyses
Perguntas frequentes
Quando o RNA-seq é preferível ao DNA-seq em doenças raras?
O RNA-seq é preferível quando o DNA-seq é negativo ou inconclusivo e há suspeita de splicing aberrante, variante intrónica profunda ou efeito regulador que só se manifesta ao nível do transcrito. Estudos publicados mostram aumento da taxa de diagnóstico de 31% para 38% em algumas séries ao adicionar RNA-seq à investigação genómica padrão, segundo esta revisão.
Qual a diferença prática entre bulk RNA-seq e scRNA-seq?
O bulk RNA-seq mede a expressão média de todas as células de uma amostra, ideal para sinais consistentes em coortes maiores. O scRNA-seq resolve heterogeneidade celular, mas custa mais e envolve maior ruído técnico por amostra.
Quando usar um ensaio de minigene em vez de RT-PCR direta?
Usa-se RT-PCR direta quando há RNA do paciente com expressão suficiente do gene de interesse. Recorre-se ao ensaio de minigene quando o tecido relevante é inacessível, clonando a região genómica com a variante num vetor repórter para observar o splicing resultante.
Os organoides substituem sempre amostras clínicas em RNA-seq?
Não sempre; substituem-nas quando o tecido do paciente não é acessível ou não expressa o gene relevante. Organoides tridimensionais captam interações intercelulares e assinaturas pré-sintomáticas que amostras clínicas indiretas, como fibroblastos, frequentemente não revelam.
Que ferramentas detetam splicing aberrante em dados de RNA-seq?
LeafCutter identifica clusters de junções de splicing diferencial sem depender de anotações completas, enquanto MAJIQ quantifica variação local de splicing com sensibilidade a eventos complexos. SpliceAI e Pangolin preveem computacionalmente o efeito de variantes antes da validação experimental.