
有效的多药联合治疗筛查(combination therapy screening)应以可量化的效能终点为目标,采用锚药加化合物库的高效设计,再结合合适的协同评估模型(如 ECB、Bliss、Loewe)交叉验证,并以分子标志物与体内实验闭环收尾。下文按目的、设计、平台、模型、数据分析到验证的顺序展开,给出每一步的具体做法与常见陷阱。
简述:
- 多药联合治疗筛查应以可量化的效能终点为目标,避免只追求协同效应,而是关注高效但不一定协同的组合效果。
- 设计合理的筛查平台包括锚药加化合物库、矩阵和多射线方式,结合剂量点的合理覆盖,优化筛查效率与数据质量。
- 评价模型应结合不同假设采用多种方法进行交叉验证,以确保筛查结果的可靠性和临床转化价值。
- 数据分析中需采用合适的曲线拟合、异常值处理和稳健性检验,确保IC50/Emax等指标的准确性。
- 结合分子生物标志物和体内验证,能显著提升候选组合的临床转化成功率。
目录
- 联合治疗筛查的目标与可操作性评估
- 实验设计:矩阵、固定比率与锚药—化合物库策略
- 筛查平台与规模:自动化、成像与主动学习方法
- 协同与交互评估的数学模型:Bliss、Loewe、HSA、CI 与响应面
- 数据采集与分析实务:曲线拟合、IC50/Emax 与稳健性检验
- 从命中到优先级:生物标志物关联与体内验证路径
- 实验偏差、质控与可复现性清单
- Hopeatrarelabs 的可执行流程示例
- 快速落地的五步实践清单
- 联合筛查方法在近期研究中的位置
- 如何与 Hopeatrarelabs 合作
- 主要参考文献与延伸阅读
- 来源
- 常见问题
联合治疗筛查的目标与可操作性评估
多数团队一开始就把"协同"当成唯一标准,这其实是个误区。严格意义上的协同(synergy)在真实筛查数据中不常见,大量真正有效的组合其实只是"高效但不协同",这类组合正是 ECB(可行组合效益)概念试图捕捉的对象。这个理论已经在泛癌组合筛查研究中得到验证,其体内预测效果优于只盯着协同分数的传统做法。
设定可操作终点,需要提前明确几类量化指标:
- Emax:组合能达到的最大抑制效果,判断组合是否真正提升了疗效上限。
- IC50:达到半数抑制所需浓度,反映效力而非效果强度。
- ΔIC50 / ΔEmax:组合相对单药的变化量,直接量化"加了第二个药到底值不值"。
- 命中阈值:例如设定 Emax 低于 50% 才算候选组合,具体阈值应随研究阶段调整。
机制探索阶段可以放宽阈值,容忍更多假阳性;一旦进入临床转化导向的确认阶段,就该收紧标准,优先要求剂量比经过优化的重复验证数据。
实验设计:矩阵、固定比率与锚药—化合物库策略
设计选错,后面所有分析都是在给错误的数据"美颜"。三种主流设计各有适用场景。
- 全矩阵设计:对每对药物在多个剂量组合下逐格测试,信息最完整,但规模随药物数量呈平方级增长,一旦纳入几十个化合物就迅速变得不可承受,通常只适合验证阶段的小规模精细刻画。
- 锚药加化合物库设计:固定一个或几个"锚药",让它们分别与整个化合物库中的每个药物组合,测试量随库大小线性增长而非平方增长。这是大规模发现阶段的主力设计,能在有限预算下扫过成百上千种候选。
- 多射线(固定比率)设计:沿着几个固定的剂量比"射线"采样,而不是铺满整个矩阵,特别适合确定最佳剂量比、绘制等效线图(isobologram)。高通量组合筛查方法综述详细列出了这类设计的板布局与协同评分操作细节。
剂量点的选择同样关键:至少要覆盖每个药物的 EC50 附近区域,同时保留一到两个低于 EC50 的子阈值点,用来捕捉在低浓度下才显现的协同效应;最高测试浓度则要参照体内可达到的血药浓度或已知毒性上限设置,避免在生物学不相关的浓度区间浪费实验资源。
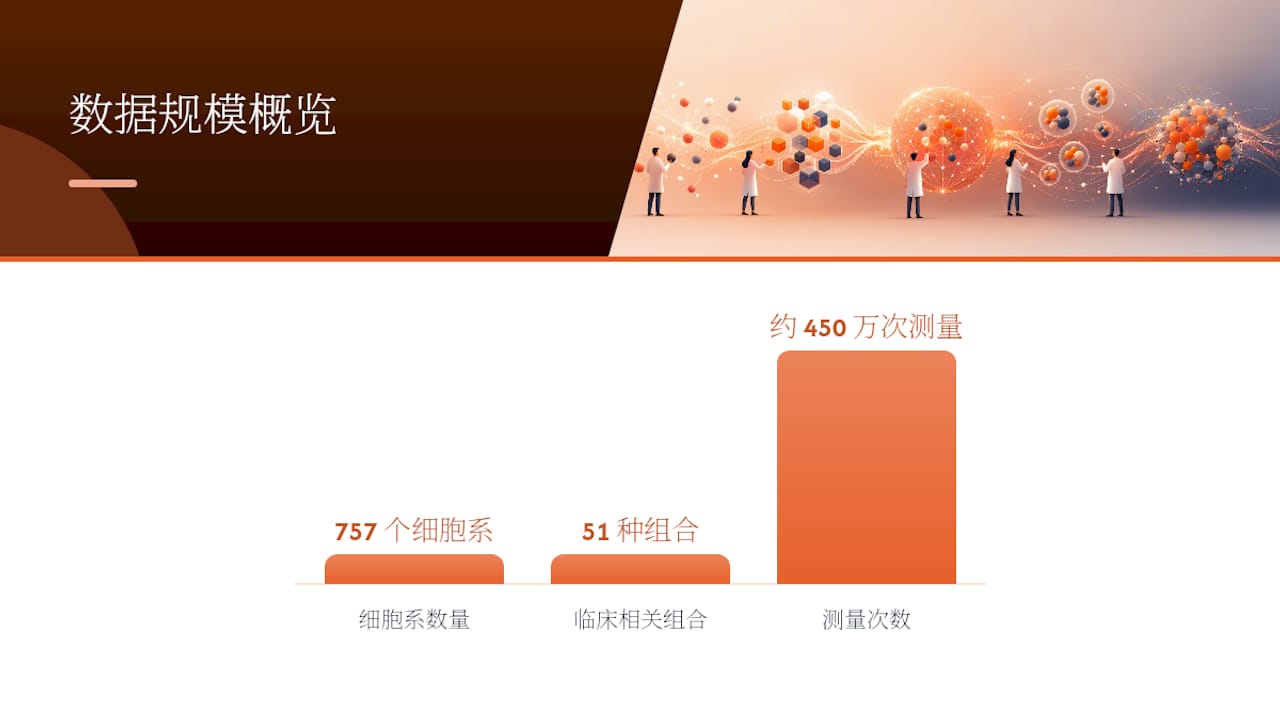
一个真实规模的参照点:某项 2024 年的泛癌筛查研究在 755 个细胞系上测试了 109 种组合,产生超过 400 万条敏感性测量。这个体量放在锚药加化合物库的框架下才是可行的,如果用全矩阵设计根本无法承受。
筛查平台与规模:自动化、成像与主动学习方法
平台选择本质上是在通量、表型信息量和成本之间做取舍,没有一种平台能同时把三者都拉满。
- 自动化液体处理:适合 384 孔或 1536 孔板规模的高通量筛查,是锚药加化合物库设计的标配基础设施,但通常只输出单一终点(如活力或荧光信号)。
- 高内涵成像:能同时捕捉细胞形态、亚细胞定位、多种荧光标记等数十个表型维度,信息密度远高于单终点读数,代价是图像分析和数据存储的负担会陡增,团队需要提前规划好图像处理流水线。
- 主动学习与贝叶斯序贯设计:不再一次性铺开全部组合,而是每轮根据已有数据预测哪些组合最值得测,动态调整下一轮实验。这类方法能把原本随组合数量指数增长的实验负担压缩到接近线性水平,让探索更大规模的化合物空间变得现实可行。
专业提示: 不要把主动学习当成万能替代品。它在缩小搜索空间上确实高效,但前期几轮的探索性数据质量直接决定后续预测的准确度,第一批数据草率,后面全盘皆输。
三种技术并非互斥,实践中常见的组合是先用自动化液体处理跑一轮锚药加化合物库的粗筛,再用高内涵成像对入围的候选做精细表型刻画,最后用主动学习指导第三轮的剂量优化实验。
协同与交互评估的数学模型:Bliss、Loewe、HSA、CI 与响应面
选错评价模型,等于用错误的尺子量东西,结果自然经不起推敲。每种模型背后的假设不同,适用场景也不同。
- Bliss 独立模型:假设两药作用机制彼此独立,通过概率乘法预测期望效果,适合快速筛选阶段的初步打分。
- Loewe 相加模型:假设两药本质上是同一种药的不同剂量,是等效线图分析和组合指数(CI)计算的理论基础。
- 最高单药效应(HSA):只要组合效果超过任一单药的最佳表现即视为有意义,标准最宽松,适合发现阶段避免漏掉候选。
- 组合指数(CI):基于中位效应方程量化协同、相加或拮抗的程度,中位效应理论为这套计算体系与配套的等效线图、剂量减少指数(DRI)可视化提供了数学基础。
- 响应面模型:把整个剂量组合空间拟合成连续曲面,能同时刻画多个剂量比下的交互模式,比单点 CI 值提供更完整的图景,但需要更密集的数据点支撑。
effect-based 方法(如 Bliss、HSA)计算简单、对数据量要求低,适合初筛;dose–effect-based 方法(如 Loewe、CI)更依赖完整的剂量反应曲线,适合确认阶段的精细刻画。方法学综述明确指出,没有单一模型适用于所有情形,建议在发现阶段用多个模型并行打分,再以 ECB 这类效能导向的宽松指标做二次筛选,避免因为过度纠结"是否协同"而漏掉真正有临床价值的组合。
数据采集与分析实务:曲线拟合、IC50/Emax 与稳健性检验
原始读数变成可信的 IC50 或 Emax,中间要经过几道容易出错的工序。
- 选择合适的拟合模型:多数剂量反应数据用四参数逻辑斯蒂模型(4PL)就够了,但如果曲线明显不对称,应换成五参数模型(5PL),强行套用 4PL 会系统性地扭曲 IC50 估计。
- 确定权重策略:高浓度点的方差往往比低浓度点大,不加权重直接做最小二乘拟合会让曲线被高浓度端的噪声牵着走,建议采用反方差加权。
- 处理异常值:单纯靠肉眼剔除"看着不对"的点风险很高,最好用统计判据(如 Grubbs 检验)配合重复孔的一致性来判断。
关键度量的计算要点:IC50 和 Emax 直接从拟合曲线读出,ΔIC50 和 ΔEmax 是组合相对单药的变化量,剂量减少指数(DRI)则说明加入第二种药后,第一种药的剂量可以减少多少倍才能达到同等效果,是评估"减毒增效"策略的核心指标。
数据支撑: 前文提到的泛癌筛查研究在 757 个细胞系上对 51 个临床相关组合生成了约 450 万条测量,这种体量下如果不做系统性的异常值处理和权重校正,噪声很容易被误判为真实的生物学信号。
稳健性检查同样不能省:至少三次生物学重复、跨批次的交叉验证,以及用等效线图或三维响应曲面把结果可视化出来,往往能一眼看出某个"漂亮"的协同信号其实只是某一批次的伪影。剂量反应曲线的绘制与拟合实操可以作为这部分工作流的具体参考。
从命中到优先级:生物标志物关联与体内验证路径
筛出几十个甚至上百个候选组合只是第一步,真正难的是判断哪几个值得往下推进。
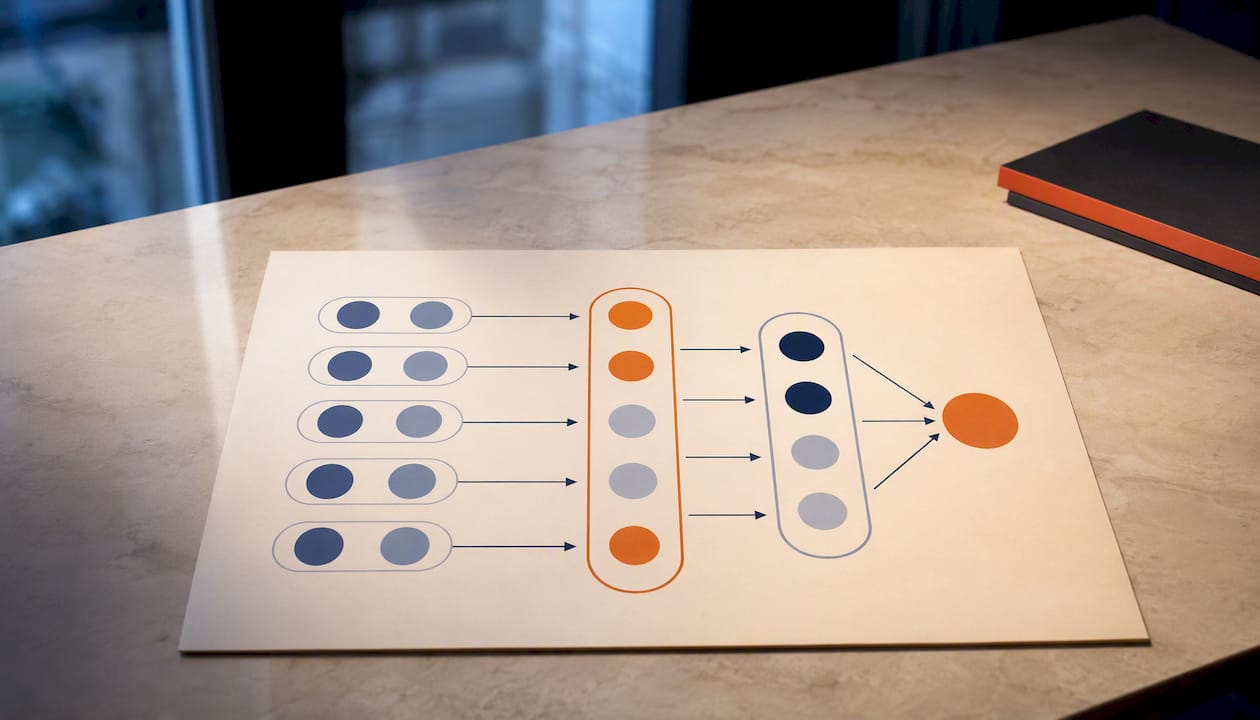
把命中结果和分子特征做关联分析是最常见的第一道筛子:基因表达谱、突变状态、蛋白表达水平都可以和响应数据做相关性分析,找出哪些分子特征能预测某个组合的敏感性。这一步产出的生物标志物假设,直接决定后续患者分层策略。
体内验证通常遵循从简单到复杂的序列:
- 先用短期体内模型(如异种移植的早期终点实验)快速排除明显无效或毒性过高的组合。
- 通过初筛的组合再推进到患者来源异种移植(PDX)模型,这一步更接近临床异质性,也更耗时耗钱。
- 对表现稳定的候选做机制研究,确认其作用通路,为后续的临床方案设计提供依据。
对于罕见病或难以招募的适应症,传统的大样本随机对照试验往往不现实。更务实的做法是采用简化的 N-of-1 设计或小型队列试验,配合患者来源细胞模型的并行筛查数据积累证据。细胞系建立对治疗决策的影响说明了选择合适的患者来源模型如何直接影响这类小样本研究的可信度。表型筛选到候选优先级的完整路径可以参考表型筛选转化为候选的三步法。
实验偏差、质控与可复现性清单
大规模筛查最怕的不是假阴性,而是系统性偏差被误读成生物学信号。以下几项是最容易被忽视、却最容易毁掉整批数据的环节。
- 随机化与板位平衡:把同一处理随机分散到板的不同位置,避免边缘效应或梯度效应被误判为处理效果。
- 阳性与阴性对照:每块板都要设置已知有效的阳性对照和空白阴性对照,用于计算 Z' 因子等板内质控指标,任何一块板质控不达标就该整块作废重做。
- 元数据记录:记录每次实验的批次号、试剂来源、孵育时间、仪器型号等信息,缺失元数据的数据集几乎无法在几个月后被重新核查或复用。
专业提示: 批次效应比大多数人想象的更隐蔽,尤其是在跨越几周甚至几个月完成的大规模筛查中。定期插入几块"锚定板",用同一批对照化合物重新测试,能及时发现仪器漂移或试剂批次差异。 完整的质控实操细节可以参考患者来源细胞系质控清单。
Hopeatrarelabs 的可执行流程示例
把上述方法落到罕见病场景中,实际路径通常是:从患者样本出发,用诱导多能干细胞(iPSC)技术建立疾病模型,再对数千种已获 FDA 批准的药物、定制反义寡核苷酸(ASO)候选进行并行筛查,最终提炼出候选方案。
- 样本采集与 iPSC/患者来源模型建立,尽量保留患者本身的遗传背景。
- 并行筛查阶段覆盖已批准药物库、定制 ASO 与基因治疗选项,采用前文所述的锚药加化合物库策略提升效率。
- 候选提炼后进入结果翻译环节,向患者、医生与合作方提供透明的进展报告。
- 质控节点设在每一轮筛查完成后,确保数据质量达标才推进到下一阶段的临床对接讨论。
快速落地的五步实践清单
把整套方法压缩成五步:先定终点,再选设计,接着定平台和质控标准,然后多模型并用做分析,最后用生物标志物和体内实验做优先级排序与验证。每一步的取舍都会影响下一步的成本和可信度。
- 定义终点:常见陷阱是终点定得太模糊,导致后期无法判断"成功"。
- 选择设计:锚药加化合物库适合发现阶段,矩阵与多射线适合确认阶段。
- 选平台与质控标准:通量、表型信息与成本三者取舍要提前想清楚。
- 多模型并用分析:单一协同指标容易漏掉高效但不协同的组合。
- 候选优先级与验证:分子标志物关联做得越早,体内验证的成功率越高。
| 步骤 | 核心决策 | 常见陷阱 |
|---|---|---|
| 定终点 | 选定 Emax/IC50 等可量化指标 | 终点模糊无法判定成功 |
| 选设计 | 锚药库 vs 矩阵 vs 多射线 | 全矩阵在大库场景下不可承受 |
| 选平台 | 通量、表型、成本三者取舍 | 只看通量忽视表型信息价值 |
| 分析建模 | Bliss/Loewe/CI/ECB 多模型并用 | 只盯协同分数漏掉高效组合 |
| 验证优先级 | 分子标志物关联 + 体内验证序列 | 跳过短期体内模型直奔 PDX 浪费成本 |
联合筛查方法在近期研究中的位置
主动学习和多组学整合正在把联合筛查从"穷举式"筛查推向"预测式"筛查,这个转向比大多数人意识到的更快。真正的瓶颈从来不是筛查通量,而是体外信号能不能转化为体内可信结果——这也是 ECB 这类效能导向指标越来越受重视的原因。我的建议是把有限的预算多分给验证阶段,而不是无限扩大发现阶段的化合物库。
— John
如何与 Hopeatrarelabs 合作
如果你面对的是罕见病或未确诊遗传病,传统的大规模药物筛查体系往往因为患者数量太少而难以启动。有些先进实验室采用患者自己的细胞建立个性化疾病模型,再在这个模型上并行筛查多种已获批药物、定制 ASO 与基因治疗选项,不需要等待足够大的患者队列才能开始寻找方案。
具体的服务范围包括疾病建模、并行药物筛查、数据分析与结果翻译,每个阶段都会向患者、家属、医生或合作的生物医药机构提供可追踪的进展报告。想启动一个项目,第一步是通过 Hopeatrarelabs 官网 提交病例信息,团队会评估建模可行性并说明预期交付物和时间节点。需要说明的是,这些内容是科研与流程信息,不构成临床医疗建议,具体治疗决策仍需由主治医生判断。
主要参考文献与延伸阅读
- 泛癌组合筛查研究:大规模筛查数据量的实际参照。
- 高通量组合筛查方法综述:板设计与协同评分操作细节。
- ECB 概念论文:效能导向评价框架的理论基础。
- 组合分析方法学综述:模型选择与分阶段流程建议。
- 中位效应与组合指数理论:CI 与等效线图的数学基础。
- NCATS 矩阵组合筛查资源:矩阵设计的入门说明。
This article is general information, not a substitute for advice from a qualified doctor. Consult a qualified healthcare professional about your own circumstances before acting on anything here.
来源
- PubMed record (2024 study)
- Methods for High-throughput Drug Combination Screening and Synergy Scoring
- Pan-cancer combination screening paper (ECB concept)
- Analysis of drug combinations: current methodological landscape
- Theoretical basis and computerized simulation of synergism
常见问题
联合治疗筛查能举一个具体例子吗?
一个典型例子是用锚药加化合物库设计,将某个已知靶向药固定,与化合物库中数千种候选逐一配对测试,再用 Bliss 或 ECB 等指标筛出效果显著提升的组合。
联合治疗筛查的目的是什么?
核心目的是找出比单药更有效、毒性更低或能克服耐药性的药物组合,尤其是在缺乏成熟单药方案的适应症中。
目前有没有专门针对癌症的新型联合用药方案?
不同癌种和分子亚型对应的联合方案差异很大,具体用药需由主治医生根据患者的基因检测结果和临床指南判断,本文不针对特定药物做推荐。
联合治疗可能带来哪些副作用?
联合用药的副作用通常是两种药物各自毒性的叠加,也可能出现单药未见的新增交互反应,具体风险需要在体内验证阶段结合毒理学数据评估,并始终由医生监督用药。
为什么筛查联合疗法比只测单药更重要?
因为很多难治性疾病对单药响应有限,组合筛查能揭示单药测试完全无法发现的效能提升或耐药突破,这也是 Hopeatrarelabs 在罕见病模型上采用并行筛查策略的原因。