
A triagem fenotípica de medicamentos (phenotypic drug screening) testa o efeito de compostos em células, tecidos ou organismos inteiros, sem exigir hipótese prévia sobre o alvo molecular. Combinada a imagens de alto conteúdo, modelos derivados de iPSC e machine learning, essa abordagem hoje produz candidatos first-in-class com mais consistência do que há uma década, segundo revisões recentes sobre PDD. O método de leitura mais usado, cell painting, já mapeia milhares de características celulares por poço.
Em resumo:
- A triagem fenotípica é mais adequada para doenças complexas ou raras onde o alvo molecular não é bem conhecido, evitando investimentos longos em hipóteses não validadas.
- Modelos de alta densidade, como culturas 2D, são ideais para triagens iniciais, enquanto iPSC, organoides e animais são usados em etapas mais avançadas, com custos e tempos crescentes.
- Perfis de imagens de alto conteúdo como cell painting oferecem insights sobre mecanismo de ação, embora exijam plataformas de triagem de diferentes tamanhos de placa dependendo da etapa do estudo.
- Testar combinações de medicamentos com análise de sinergia é raro, sendo mais útil avaliar se a combinação produz um efeito clínico relevante, independente do tipo de interação estatística.
- Sistemas de aprendizado ativo bayesiano como o BATCHIE reduzem drasticamente o número de experimentos necessários ao orientar rodadas iterativas de testes baseadas nos resultados anteriores.
Índice
- O que explica o ressurgimento da triagem fenotípica frente à descoberta baseada em alvo?
- Como escolher entre modelos 2D, iPSC, organoides e animais
- O que cell painting e imagens de alto conteúdo revelam sobre um composto?
- Quais formatos de placa e plataformas suportam a triagem em escala?
- Como interpretar sinergia, Bliss e IDA em triagens de combinação
- Como o aprendizado ativo reduz o número de experimentos necessários
- Como identificar o alvo e o mecanismo depois de um hit fenotípico
- Quais são os principais riscos ao levar um hit fenotípico para a clínica?
- Como a RareLabs conduz uma triagem fenotípica para doenças raras
- O que vem a seguir na triagem fenotípica de medicamentos
- Como iniciar um programa de triagem fenotípica com a RareLabs
- Fontes
- Perguntas frequentes
O que explica o ressurgimento da triagem fenotípica frente à descoberta baseada em alvo?
Entre 1999 e 2008, uma parcela relevante dos fármacos first-in-class aprovados veio de descobertas empíricas, sem hipótese de alvo definida de antemão. Esse padrão histórico, documentado em uma revisão sobre sucessos recentes em PDD, foi o gatilho para o interesse renovado pela triagem fenotípica a partir de 2011. A indústria farmacêutica vinha investindo pesado em descoberta baseada em alvo (target-based discovery, ou TDD) durante os anos 1990 e 2000, com resultados abaixo do esperado em doenças complexas.
Dois casos ilustram bem essa virada. O ivacaftor, usado em fibrose cística, e o risdiplam, indicado para atrofia muscular espinhal, tiveram seus mecanismos terapêuticos elucidados a partir de abordagens fenotípicas e baseadas em ensaio funcional, não de um alvo pré-selecionado. Ambos se tornaram provas de conceito citadas com frequência em discussões sobre o valor prático da PDD.
TDD e PDD não competem pelo mesmo espaço, eles resolvem problemas diferentes. Essa complementaridade aparece de forma explícita na literatura mais recente sobre o tema:
- TDD funciona melhor quando já existe um alvo validado geneticamente ou farmacologicamente, e o objetivo é otimizar afinidade e seletividade de uma molécula contra esse alvo.
- PDD funciona melhor quando a biologia da doença é pouco compreendida, quando não há alvo único dominante, ou quando o fenótipo clínico resulta de múltiplas vias interligadas — o cenário típico em boa parte das doenças raras.
- PDD exige mais trabalho posterior de desconvolução de alvo, já que o hit aparece antes do mecanismo.
- TDD tende a falhar em translação quando o alvo escolhido não é, de fato, causal para o fenótipo da doença em humanos.
Para pesquisadores avaliando doenças genéticas raras sem terapia aprovada, essa distinção importa na prática: começar pelo fenótipo do paciente, em vez de uma hipótese de alvo ainda não validada, reduz o risco de investir anos em um mecanismo que nunca foi a causa real do problema.
Como escolher entre modelos 2D, iPSC, organoides e animais
A escolha do modelo biológico determina o que a triagem consegue de fato responder. Não existe um modelo universalmente melhor. Existe o modelo certo para a pergunta que você está fazendo, e errar essa escolha custa meses de trabalho em dados que não se traduzem para a clínica.
Culturas 2D convencionais continuam relevantes para triagens de alto rendimento (HTS) iniciais, quando o objetivo é reduzir uma biblioteca de milhares de compostos para centenas de candidatos. São baratas, reprodutíveis e compatíveis com automação em placas de alta densidade. O problema aparece quando a doença depende de arquitetura tecidual, interação entre tipos celulares ou maturação funcional que uma monocamada simplesmente não replica.
Modelos derivados de células-tronco pluripotentes induzidas (iPSC) resolvem parte dessa limitação. Reprogramadas a partir de células do próprio paciente, elas preservam o contexto genético exato daquele indivíduo, algo particularmente valioso em doenças raras onde cada paciente pode carregar uma variante distinta do mesmo gene. Organoides derivados de iPSC vão além, recriando estrutura tridimensional e comunicação entre tipos celulares, o que aumenta a relevância fisiológica sem exigir um modelo animal completo.
Modelos animais permanecem indispensáveis quando a pergunta envolve fisiologia sistêmica: farmacocinética, resposta imune integrada, ou fenótipos que só se manifestam com interação entre múltiplos órgãos. A limitação é conhecida: baixo throughput, custo elevado por experimento e, em muitos casos, uma correlação imperfeita entre o fenótipo murino e o fenótipo humano da mesma mutação.
Os trade-offs práticos ficam assim:
- Relevância biológica sobe de 2D para iPSC/organoides para animal, mas o throughput cai na mesma proporção.
- Custo por ponto de dado é baixo em 2D, moderado em iPSC/organoides e alto em modelos animais.
- Tempo até o primeiro resultado varia de dias (2D), as semanas (organoides) e a meses (estudos in vivo).
- Capacidade de capturar heterogeneidade de paciente é praticamente exclusiva de plataformas baseadas em iPSC.
Dica profissional: Comece a triagem primária em 2D ou iPSC 2D para reduzir a biblioteca, depois valide os top hits em organoides ou em um modelo animal restrito. Fazer o caminho inverso, testar tudo direto em modelo complexo, é a forma mais comum de estourar orçamento e cronograma em programas de doenças raras.
O que cell painting e imagens de alto conteúdo revelam sobre um composto?
Um ensaio de viabilidade celular responde uma pergunta binária: a célula sobreviveu ou não. Cell painting responde centenas de perguntas ao mesmo tempo, sobre forma do núcleo, textura do citoplasma, morfologia mitocondrial, organização do citoesqueleto e mais uma dezena de compartimentos celulares corados simultaneamente.
Cell painting mede tipicamente mais de 1.500 características morfológicas por célula, segundo a literatura sobre esse método de perfil fenotípico. Esse volume de dados é o que permite comparar a "assinatura" de um composto desconhecido com a assinatura de compostos com mecanismo já conhecido.
Essa densidade de informação é o que torna cell painting útil para inferência de mecanismo de ação (MoA), não apenas para separar "ativo" de "inativo". Dois compostos podem matar a mesma proporção de células e, ainda assim, produzir perfis morfológicos completamente diferentes, um por indução de apoptose clássica, outro por estresse mitocondrial, por exemplo. Essa diferença aparece no perfil de imagem muito antes de qualquer ensaio bioquímico confirmar o mecanismo.
Os tipos de leitura fenotípica se organizam em níveis de complexidade crescente:
- Readouts de viabilidade simples: rápidos e baratos, servem para triagem primária de eliminação, mas não distinguem mecanismo.
- Ensaios funcionais dirigidos: medem um parâmetro específico da doença, como corrente iônica em canalopatias ou secreção de uma proteína.
- Imagens de alto conteúdo multiparamétricas: cell painting e variações, geram perfis de centenas a milhares de features por poço.
- Biossensores multiplexados com código de barras de DNA: permitem agrupar dezenas de alvos ou perturbações no mesmo poço, reduzindo custo por teste em triagens de larga escala.
A escolha entre esses níveis depende do estágio do programa. Triagem primária de eliminação não precisa da riqueza de cell painting, sairia caro sem necessidade. Já a etapa de priorização de hits, quando restam algumas dezenas de candidatos e a pergunta virou "qual desses provavelmente compartilha mecanismo com um fármaco já validado", é exatamente onde perfis de alto conteúdo compensam o investimento. Padronizar iluminação e incluir controles de placa em cada corrida reduz variação técnica, um detalhe que faz diferença real quando a análise depende de comparar milhares de features entre placas diferentes.
Quais formatos de placa e plataformas suportam a triagem em escala?
O formato de placa escolhido define, na prática, quanto material biológico e quanto reagente o programa vai consumir por candidato testado. Placas variam de 96 até 6144 poços, e plataformas automatizadas de alto rendimento já suportam esse intervalo completo com processamento paralelo.
Placas de 96 e 384 poços continuam sendo o padrão para ensaios que exigem modelos mais complexos, como organoides ou culturas 3D, onde o volume por poço precisa ser maior para sustentar a estrutura tecidual. Formatos de 1536 e 3456 poços entram em cena quando a biblioteca é grande e o modelo é 2D ou baseado em biossensor, permitindo testar milhares de compostos com uma fração do reagente que o formato de 96 poços exigiria. No extremo de 6144 poços, o ganho de throughput é real, mas a margem de erro operacional cai proporcionalmente, e a automação deixa de ser opcional.
Microfluídica e chips bioimpressos (bioprinted) surgem como alternativa quando o objetivo é reduzir consumo de reagente sem abrir mão de complexidade estrutural. Um chip microfluídico pode manter um modelo de órgão em miniatura funcionando por dias com volumes de meio de cultura ordens de magnitude menores que uma placa convencional, viabilizando HTS mesmo com modelos 3D que normalmente seriam caros demais para escalar.
Para pesquisadores planejando uma triagem paralela em larga escala, as decisões operacionais mais relevantes são:
- Tamanho da biblioteca determina o piso mínimo de formato de placa viável economicamente.
- Complexidade do modelo (2D versus 3D versus organoide) restringe o teto de miniaturização possível.
- Disponibilidade de automação de pipetagem vira gargalo real acima de 1536 poços.
- Custo de reagente por ponto de dado deve ser calculado antes de escolher o formato, não depois.
Programas que testam milhares de moléculas de uma biblioteca aprovada pela FDA contra um modelo de paciente específico normalmente combinam formatos: triagem primária em placas de alta densidade, seguida de confirmação em placas de 96 ou 384 poços com o modelo mais próximo da fisiologia real.
Como interpretar sinergia, Bliss e IDA em triagens de combinação
A maior parte das combinações de fármacos testadas não é sinérgica. Isso surpreende quem espera que combinar dois compostos ativos produza, quase sempre, um efeito maior que a soma das partes. Não é o que os dados mostram.
Em uma triagem pan-câncer com 757 linhagens celulares e 51 combinações clinicamente relevantes, apenas cerca de 11% das respostas mostraram sinergia verdadeira, enquanto aditividade de Bliss e independência de dose-adição (IDA) explicaram a maioria dos casos. Esse dado muda a forma como um programa deveria priorizar combinações: perseguir sinergia estatística como critério único descarta a maioria das combinações clinicamente úteis.
Os três modelos de referência funcionam assim:
- Sinergia ocorre quando o efeito combinado supera o esperado pela soma dos efeitos individuais, o cenário mais raro e mais difícil de prever.
- Aditividade de Bliss assume independência estatística entre os dois compostos e prevê o efeito combinado a partir dessa premissa, servindo como linha de base de comparação.
- Independência de dose-adição (IDA) trata os dois compostos como se fossem diluições do mesmo composto, útil quando ambos atuam por vias relacionadas.
Diante da raridade da sinergia real, a mesma análise pan-câncer propôs um conceito mais prático: o benefício de combinação eficaz (ECB, na sigla em inglês). Em vez de perguntar "esses dois compostos interagem de forma sinérgica", o ECB pergunta "essa combinação produz um efeito clinicamente relevante, independentemente do tipo de interação matemática por trás dele". Para um programa de doenças raras com poucos pacientes e pouco tempo, essa é a pergunta que realmente importa, priorizar eficácia absoluta em vez de elegância estatística é uma escolha defensável e, na maioria dos casos, mais translacional.
Desenhos de triagem combinatória seguem duas lógicas principais. Matrizes completas testam todas as combinações de dose entre dois ou mais compostos, gerando um mapa de resposta rico, mas caro em número de poços. Designs ancorados fixam a dose de um composto (geralmente o de referência clínico) e variam apenas o parceiro de combinação, reduzindo drasticamente o número de experimentos necessários ao custo de perder resolução sobre a relação de dose completa. A escolha entre os dois depende de quantos compostos parceiros o programa pode se dar ao luxo de testar em profundidade, um tema explorado com mais detalhe em discussões sobre terapia combinada em doenças raras.
Como o aprendizado ativo reduz o número de experimentos necessários
Um pipeline analítico típico de triagem fenotípica segue quatro etapas: extração de características a partir da imagem ou do sinal bruto, normalização entre placas e lotes, redução de dimensionalidade para tornar o espaço de dados manejável, e finalmente modelagem para classificar ou pontuar compostos. Cada etapa introduz ruído se malfeita, e normalização entre placas costuma ser o ponto onde mais problemas de reprodutibilidade se escondem.
O gargalo real de triagens combinatórias não é analítico, é combinatório. Testar todas as combinações possíveis entre centenas de compostos em múltiplas doses gera um número de experimentos que cresce rápido demais para qualquer orçamento realista. É aqui que aprendizado ativo bayesiano muda o jogo.
A plataforma BATCHIE, descrita em um estudo publicado na Nature Communications, demonstrou identificar combinações eficazes explorando uma fração pequena do espaço experimental total, algo em torno de 4% das combinações possíveis em um dos exemplos analisados. O princípio por trás disso é simples de entender mesmo sem formação em estatística bayesiana: depois de cada rodada de experimentos, o modelo atualiza sua estimativa sobre quais combinações têm maior probabilidade de serem informativas, e a próxima rodada testa justamente essas, em vez de seguir uma grade fixa predefinida.
Isso muda a forma como um programa de triagem deveria ser desenhado do zero:
- Rodadas iterativas pequenas superam uma única rodada gigante em eficiência de descoberta.
- O modelo aprende com cada resultado, então o desenho experimental da segunda rodada nunca deveria ser idêntico ao da primeira.
- Algoritmos como BATCHIE são de código aberto, o que reduz a barreira de adoção para laboratórios acadêmicos e biotechs menores.
- A prioridade computacional não substitui validação experimental, ela apenas direciona onde gastar o experimento seguinte com mais eficiência.
Dica profissional: Desconfie de qualquer modelo de active learning que converge rápido demais para um único candidato. Isso costuma indicar viés herdado dos dados de treinamento, não descoberta genuína. Reserve sempre uma fração do orçamento experimental para testar combinações que o modelo classificou como incertas, não apenas as que ele classificou como promissoras.
Como identificar o alvo e o mecanismo depois de um hit fenotípico
Encontrar um composto que reverte o fenótipo da doença é só metade do trabalho em PDD. A outra metade, muitas vezes mais longa, é descobrir por que aquele composto funciona, um processo chamado desconvolução de alvo.
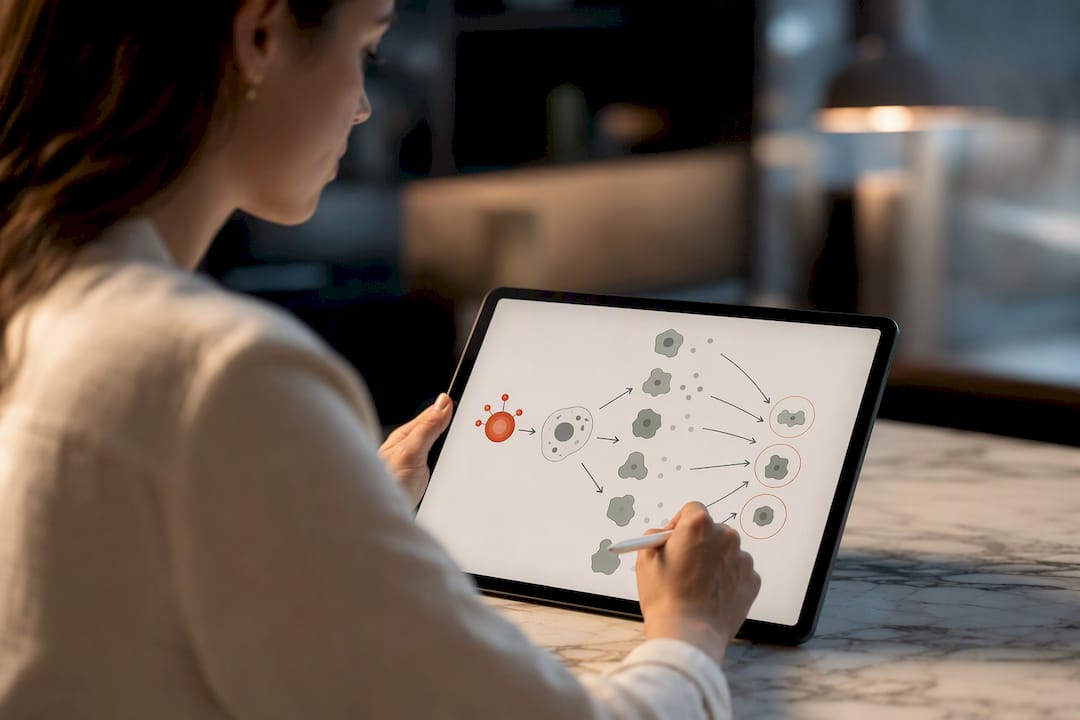
Três abordagens dominam essa etapa. Chemoproteomics usa o próprio composto, quimicamente modificado com uma sonda, para "pescar" as proteínas às quais ele se liga dentro da célula, revelando alvos diretos com evidência física de interação. Perturbações com CRISPR testam sistematicamente se o silenciamento ou a ativação de genes candidatos reproduz o efeito fenotípico observado, funcionando como confirmação genética independente da química. Estudos de relação estrutura-atividade (SAR), combinados a painéis farmacológicos que testam o composto contra baterias conhecidas de alvos, ajudam a restringir o mecanismo por eliminação.
O fluxo recomendado normalmente segue esta ordem prática:
- Priorizar hits por robustez do fenótipo, não apenas por magnitude do efeito, antes de investir em desconvolução.
- Rodar chemoproteomics e triagem CRISPR em paralelo, já que cada método captura um tipo diferente de evidência mecanística.
- Cruzar os candidatos a alvo com dados de expressão gênica ou proteômica específicos da doença sempre que disponíveis.
- Validar com um ensaio funcional independente antes de declarar um mecanismo como confirmado.
Esse processo raramente é rápido. Programas bem estruturados costumam reservar de vários meses a mais de um ano só para a fase de desconvolução de alvo depois de identificar o hit inicial, um prazo que varia enormemente conforme a complexidade da doença e a disponibilidade de ferramentas genéticas para o organismo ou linhagem celular em questão. Subestimar esse tempo é um dos erros de planejamento mais comuns em programas de descoberta que partem de PDD.
Quais são os principais riscos ao levar um hit fenotípico para a clínica?
Um composto que funciona perfeitamente em cultura 2D pode falhar de três formas diferentes na clínica: toxicidade não detectada, mecanismo que não se replica em humanos, ou modelo pré-clínico que simplesmente não capturava a biologia relevante da doença. Antecipar essas armadilhas antes de avançar para investimento clínico é o que separa programas eficientes de programas que gastam anos perseguindo um mecanismo sem saída.
A cadeia de translação começa muito antes do primeiro paciente. Validar o hit em mais de um modelo biológico, idealmente cruzando dados de 2D com iPSC ou organoide do mesmo paciente, reduz a chance de estar otimizando para um artefato específico daquele sistema experimental. Conectar qualquer biomarcador identificado durante a triagem a uma medida clinicamente relevante no paciente, antes de avançar, evita descobrir tarde demais que o biomarcador não tem correspondência clínica.
Sinais de alerta que merecem atenção redobrada incluem:
- Efeito que desaparece ao trocar o clone de iPSC, sugerindo artefato de linhagem celular em vez de efeito farmacológico real.
- Toxicidade que só aparece em concentração próxima da dose eficaz, uma janela terapêutica estreita demais para viabilidade clínica.
- Ausência de efeito dose-resposta clássico, que pode indicar mecanismo fora do alvo pretendido.
- Modelo pré-clínico sem nenhum paciente geneticamente idêntico ao alvo terapêutico final, comum em doenças ultra-raras com poucas variantes conhecidas.
Dica profissional: Rode um contra-screening cedo, testando o hit contra um painel de células saudáveis ou controles isogênicos corrigidos por CRISPR. Descobrir toxicidade seletiva antes de investir em estudos animais economiza tempo e recursos que, em programas de doenças raras, quase sempre são escassos.
Como a RareLabs conduz uma triagem fenotípica para doenças raras
A RareLabs (Hopeatrarelabs) estrutura seu processo em quatro etapas conectadas, começando pela modelagem da doença a partir de células do próprio paciente. Usando reprogramação por iPSC e edição genética com CRISPR, a equipe constrói um modelo de doença geneticamente idêntico ao paciente, junto com uma linha controle corrigida para comparação direta.
Com o modelo em mãos, o programa avança para triagem paralela, testando milhares de medicamentos já aprovados pela FDA, junto com oligonucleotídeos antisenso (ASO) personalizados e opções de terapia gênica, contra o modelo específico daquele paciente. Esse desenho paralelo, em vez de sequencial, é o que permite comprimir em semanas um processo que triagens tradicionais fazem em etapas isoladas, um formato descrito com mais detalhe em materiais sobre triagem com biblioteca aprovada pela FDA.
Os resultados passam por análise e tradução, etapa em que hits candidatos são avaliados quanto à plausibilidade mecanística e à viabilidade de uso real, antes de chegarem ao paciente, à família ou ao médico responsável em formato de relatório traduzível para decisão clínica, um fluxo mais detalhado em conteúdo sobre como resultado de laboratório vira opção de tratamento.
Vale considerar iniciar um programa como esse quando:
- A doença não tem terapia aprovada e as opções convencionais de pesquisa já se esgotaram.
- Existe urgência clínica que torna o cronograma de descoberta tradicional inviável.
- A variante genética do paciente é rara o suficiente para não constar em programas farmacêuticos de grande escala.
O que vem a seguir na triagem fenotípica de medicamentos
Bibliotecas de degradadores direcionados a proteína (TPD) e plataformas de microdroplet escaláveis, como as descritas em estudos recentes sobre triagem combinatória em droplets, vão ampliar o espaço químico testável sem multiplicar custo de reagente na mesma proporção. Isso é bom, mas resolve só parte do problema.
A limitação real de PDD nunca foi gerar dados, é integrar dados de naturezas diferentes. Um perfil de imagem de cell painting, um perfil transcriptômico e um resultado funcional raramente conversam entre si de forma automática, e é aí que abordagens multi-ômicas integradas, combinadas a frameworks computacionais mais recentes para PDD, prometem mais do que qualquer avanço isolado em throughput.
Isso exige um tipo de colaboração que a área ainda não domina bem: biólogo celular, cientista de dados e clínico trabalhando na mesma mesa de decisão, não em silos sequenciais. Quem resolver esse gargalo organizacional antes de resolver o gargalo tecnológico vai sair na frente. As áreas com maior potencial de impacto translacional nos próximos anos provavelmente estão em doenças raras com poucos pacientes, onde cada dado tem peso desproporcional e a colaboração apertada entre disciplinas deixa de ser luxo e vira necessidade.
— John
Como iniciar um programa de triagem fenotípica com a RareLabs
Programas de descoberta tradicional costumam levar anos e exigir uma hipótese de alvo já validada, um luxo que famílias enfrentando uma doença ultra-rara sem diagnóstico definitivo raramente têm.
Um laboratório especializado resolve esse problema construindo um modelo da doença a partir das próprias células do paciente usando iPSC e CRISPR, seguido de triagem paralela contra medicamentos aprovados, oligonucleotídeos antisenso personalizados e opções de terapia gênica, tudo simultaneamente em vez de em etapas isoladas. Vale considerar esse caminho quando a doença não tem terapia aprovada, quando o tempo é um fator crítico, ou quando a variante genética específica do paciente é rara demais para constar em qualquer programa farmacêutico convencional. Médicos e fundações que acompanham famílias nessa situação encontram contexto adicional em materiais sobre apoio a diagnóstico raro. Para começar um programa personalizado de modelagem e triagem, o próximo passo é entrar em contato pelo site da RareLabs e apresentar o caso clínico específico à equipe.
Fontes
Para quem quer aprofundar os métodos discutidos aqui, os textos abaixo sustentam a maior parte das evidências citadas neste artigo.
A revisão sobre sucessos recentes em PDD traça a história do ressurgimento da triagem fenotípica desde 2011. O estudo pan-câncer sobre combinações introduz o conceito de ECB com dados de 757 linhagens celulares. A descrição técnica de cell painting detalha a metodologia de imagem de alto conteúdo. O artigo sobre BATCHIE documenta o uso de active learning bayesiano em triagens combinatórias. Por fim, a revisão sobre PDD computacional discute a integração de machine learning e multi-ômicas na descoberta fenotípica moderna.
- Phenotypic Drug Discovery: Recent successes, lessons learned and new directions
- A Bayesian active learning platform for scalable combination drug screens
Perguntas frequentes
O que é triagem fenotípica de medicamentos?
É a avaliação do efeito de compostos em células, tecidos ou organismos inteiros, observando mudanças no fenótipo em vez de partir de um alvo molecular pré-definido, uma abordagem que voltou a ganhar força desde 2011.
Para que servem os ensaios fenotípicos na prática?
Ensaios fenotípicos servem para identificar compostos que revertem ou modulam um fenótipo de doença, inferir mecanismo de ação por meio de perfis de imagem como cell painting, e priorizar candidatos para desenvolvimento clínico antes mesmo de conhecer o alvo exato.
Como funciona o teste de fenótipo em um programa de descoberta?
O teste de fenótipo expõe um modelo biológico (célula 2D, organoide iPSC ou modelo animal) a uma biblioteca de compostos e mede alterações mensuráveis, morfológicas ou funcionais, comparando o resultado a controles saudáveis e a compostos de mecanismo conhecido.
Quais tipos de fenótipos aparecem com mais frequência em triagens?
Os fenótipos avaliados costumam incluir morfologia celular (forma, tamanho, textura de organelas), viabilidade e proliferação, atividade funcional específica (secreção, sinalização elétrica) e resposta a estresse ou toxicidade, cada um capturado por uma leitura diferente.
A RareLabs participa desse tipo de triagem?
Sim. A RareLabs conduz triagens fenotípicas paralelas usando modelos de doença derivados de iPSC do próprio paciente, testando bibliotecas de medicamentos aprovados pela FDA, ASOs personalizados e opções de terapia gênica para doenças raras sem tratamento estabelecido.