
A integração multi-ômica combina dados de genômica, transcriptômica, proteômica, metabolômica e outras camadas moleculares para revelar mecanismos biológicos que nenhuma ômica isolada consegue capturar. Segundo uma revisão técnica recente, essa abordagem permite identificar relações causais, biomarcadores e alvos terapêuticos em doenças complexas com uma profundidade impossível em análises separadas. A escolha da estratégia de integração depende diretamente da sua pergunta biológica e da estrutura dos dados disponíveis.
Três estratégias principais organizam o campo, conforme revisão abrangente de métodos não supervisionados:
- Estágio inicial (data-ensemble / DatE): concatene as matrizes ômicas antes da modelagem. Use quando os dados são pareados, bem normalizados e a pergunta exige capturar correlações cruzadas desde o início. Ferramentas como MOFA2 e mixOmics funcionam bem aqui.
- Estágio intermediário (model-ensemble / ModE): integre durante a modelagem, aprendendo representações conjuntas. Indicado para dados heterogêneos ou quando diferentes ômicas têm tamanhos de amostra distintos. Similarity Network Fusion (SNF) e iClusterPlus são referências nessa categoria.
- Estágio final (multi-step / MS-SA): treine modelos separados por ômica e combine os resultados. Mais tolerante a dados faltantes e útil quando as ômicas têm qualidades muito diferentes.
Para começar rapidamente:
- Se o objetivo é subtipagem molecular, priorize métodos de clustering e kernel (SNF, NMF, iClusterPlus) com dados do TCGA ou GTEx como referência.
- Se o objetivo é descoberta de biomarcadores causais, prefira redes e análise de associação multivariada (MOFA2, ARACNe, abordagens de propagação em rede).
- Se o objetivo é predição de desfecho clínico, avalie modelos supervisionados com integração intermediária e valide com métricas como AUC em coortes independentes.
Principais conclusões
A integração multi-ômica bem-sucedida depende de alinhar estratégia de integração, qualidade de pré-processamento e critérios de validação biológica desde o início do projeto.
| Ponto | Detalhes |
|---|---|
| Estratégia depende da pergunta | Subtipagem pede clustering (SNF, NMF); biomarcadores pedem PLS/MOFA2; predição pede integração intermediária supervisionada. |
| Pré-processamento é crítico | Sem normalização por bloco e correção de batch, a ômica de maior dimensionalidade domina e os resultados são artefatos. |
| Validação biológica é obrigatória | Enriquecimento em vias, co-localização com QTLs e validação experimental em modelos celulares são os critérios que diferenciam achados reais de ruído. |
| Ferramentas abertas e acessíveis | MOFA2, mixOmics, SNFtool, iClusterPlus e Seurat são código aberto, com tutoriais no Bioconductor e no EBI. |
| Hopeatrarelabs | Oferece programas integrados de modelagem iPSC, multi-ômica e triagem de compostos para doenças raras sem tratamento aprovado. |
Índice
- Quais tipos de dados ômicos existem e onde encontrá-los?
- Para que serve a integração multi-ômica na prática?
- Como funcionam as estratégias de integração ômica?
- Métodos de regressão e associação multivariada: CCA, PLS e análise fatorial
- Como métodos de clustering multi-ômico funcionam na prática?
- Por que abordagens baseadas em redes capturam o que outros métodos perdem?
- Quando vale usar modelos de deep learning em análises multi-ômicas?
- Pré-processamento: o que fazer antes de integrar os dados?
- Como avaliar se uma integração multi-ômica funcionou?
- Quais ferramentas usar e como acessá-las no Brasil?
- Estudo de caso: integração multi-ômica em doenças raras
- Roteiro prático para escolher e iniciar uma integração multi-ômica
- Perspectiva prática para pesquisadores brasileiros
- A Hopeatrarelabs oferece programas especializados para doenças raras
- Fontes
Quais tipos de dados ômicos existem e onde encontrá-los?
As camadas ômicas diferem não apenas no que medem, mas nos formatos de arquivo, escalas numéricas e desafios de integração. Entender essas diferenças operacionais antes de montar um pipeline poupa semanas de retrabalho.
- Genômica (DNA): variantes (SNPs, CNVs, indels); arquivos VCF/PLINK; desafio principal é a alta esparsidade e a necessidade de imputação de genótipos.
- Epigenômica: metilação de DNA (arrays Illumina 450K/EPIC, bisulfite-seq) e marcas de histonas (ChIP-seq); valores beta entre 0 e 1; sensível a contaminação celular.
- Transcriptômica: RNA-seq (contagens brutas, TPM, FPKM) e microarray (intensidades log2); diferença de plataforma exige harmonização cuidadosa antes de qualquer integração.
- Proteômica: espectrometria de massas (intensidades, LFQ) ou arrays de anticorpos; cobertura parcial do proteoma e muitos valores faltantes são a norma.
- Metabolômica: LC-MS ou NMR; intensidades de picos normalizadas; alta variabilidade técnica entre lotes.
- Lipidômica: subconjunto da metabolômica com foco em lipídios; mesmos desafios de espectrometria de massas, com nomenclatura própria.
- Single-cell (scRNA-seq, scATAC-seq): matrizes esparsas de contagem por célula; requer ferramentas específicas como Seurat para controle de qualidade e integração de lotes.
| Ômica | O que mede | Unidades típicas | Formatos comuns | Desafio de integração |
|---|---|---|---|---|
| Genômica | Variantes de DNA | Alelos, dosagem | VCF, PLINK BED | Esparsidade, imputação |
| Epigenômica | Metilação, cromatina | Beta/M-value, contagens | IDAT, BED, bigWig | Confundimento celular |
| Transcriptômica | Expressão de RNA | Contagens, TPM | FASTQ, count matrix | Plataforma (seq vs array) |
| Proteômica | Abundância proteica | Intensidade LFQ | mzML, tabelas TSV | Cobertura parcial, missing |
| Metabolômica | Metabólitos | Intensidade de pico | mzXML, tabelas | Variabilidade de lote |
| Single-cell | Expressão por célula | UMI counts | MEX (10x), h5ad | Esparsidade extrema |
Repositórios públicos essenciais
Os principais repositórios para análise de ômicas integradas são:
- TCGA (The Cancer Genome Atlas): dados multi-ômicos de mais de 30 tipos de câncer; referência para benchmarking e subtipagem.
- GEO (Gene Expression Omnibus, NCBI): maior repositório de dados de expressão gênica; aceita RNA-seq, microarray, ChIP-seq e single-cell.
- ArrayExpress (EMBL-EBI): repositório europeu com foco em dados funcionais genômicos; integrado ao Expression Atlas.
- GTEx (Genotype-Tissue Expression): dados de expressão e genótipos em múltiplos tecidos humanos; referência para análises de eQTL.
- CPTAC (Clinical Proteomic Tumor Analysis Consortium): proteômica e fosfoproteômica integradas com dados do TCGA.
- ICGC (International Cancer Genome Consortium): dados de sequenciamento de câncer em escala global, com participação de grupos brasileiros.
Para pesquisadores no Brasil, o acesso ao TCGA e GEO é gratuito e direto. Dados controlados do TCGA (como dados de nível 1) exigem aprovação pelo dbGaP, processo que pode levar algumas semanas. O ICGC tem projetos nacionais coordenados pelo INCA, o que facilita colaborações locais.
Dica profissional: Antes de baixar qualquer coorte pública, verifique a completude dos metadados clínicos (idade, sexo, estágio, plataforma de sequenciamento e centro de coleta). Coortes com metadados incompletos ou inconsistentes comprometem a correção de batch e a interpretação biológica mais do que qualquer limitação metodológica.
Para que serve a integração multi-ômica na prática?
A escolha do método de integração começa pela pergunta biológica. Cada objetivo exige uma arquitetura diferente de análise e métricas de sucesso distintas.
-
Subtipagem molecular: identificar grupos de pacientes com perfis moleculares distintos e, potencialmente, respostas terapêuticas diferentes. Métricas: coesão de clusters (silhouette score), estabilidade por reamostramento, enriquecimento em vias por subtipo. Exemplo clássico: subtipagem de glioblastoma e câncer de mama no TCGA usando dados de metilação, expressão e CNV simultaneamente.
-
Descoberta de biomarcadores: encontrar assinaturas moleculares que predizem diagnóstico, prognóstico ou resposta a tratamento. Métricas: AUC, sensibilidade/especificidade em coorte de validação independente, replicabilidade entre plataformas. Estudos de doenças neurodegenerativas têm combinado transcriptômica de sangue periférico com proteômica de LCR para identificar biomarcadores de progressão.
-
Predição de desfecho e alvos terapêuticos: modelos supervisionados que integram ômicas para prever sobrevida, recidiva ou resposta a drogas. A integração intermediária tende a superar modelos de ômica única nesse cenário, especialmente quando as ômicas capturam aspectos complementares do fenótipo.
-
Análise de vias e módulos: identificar conjuntos de genes, proteínas ou metabólitos co-regulados que definem um processo biológico. Ferramentas de enriquecimento (GSEA, ORA) e análise de módulos de rede são centrais aqui.
-
Doenças raras e modelos iPSC: um caso de uso crescente combina transcriptômica, proteômica e metabolômica de células iPSC derivadas de pacientes para mapear o mecanismo da doença e priorizar compostos em triagens. Essa abordagem é especialmente poderosa quando não existem coortes populacionais grandes, porque cada paciente funciona como seu próprio controle. A necessidade de modelos celulares humanos em doenças raras reforça a relevância dessa estratégia.
A ligação entre objetivo e pipeline é direta: subtipagem pede clustering não supervisionado; biomarcadores pedem seleção de features e validação cruzada; predição pede modelos supervisionados com regularização. Definir o objetivo antes de escolher o método evita o erro mais comum no campo, que é aplicar um algoritmo sofisticado sem critério de sucesso claro.
Como funcionam as estratégias de integração ômica?
A taxonomia operacional mais usada na literatura divide as abordagens em três estágios, e a escolha entre elas tem consequências diretas sobre interpretabilidade, robustez a dados faltantes e escalabilidade computacional.
Estágio inicial (DatE / concatenação) une todas as matrizes ômicas em uma única matriz antes de qualquer modelagem. É a abordagem mais simples e, em alguns benchmarks específicos, mostrou desempenho competitivo. O problema central é que, sem normalização rigorosa, a ômica com maior dimensionalidade domina a análise, conforme demonstrado em comparações de estratégias para subtipagem de tumores. Transcriptômica com dezenas de milhares de genes tende a suprimir o sinal de proteômica com algumas centenas de proteínas quantificadas se as escalas não forem equalizadas.
Estágio intermediário (ModE / integração durante a modelagem) aprende representações conjuntas das ômicas simultaneamente. SNF constrói redes de similaridade por ômica e as funde iterativamente. MOFA2 aprende fatores latentes compartilhados e específicos por ômica. iClusterPlus usa um modelo de mistura latente. Essa família de métodos lida melhor com heterogeneidade de distribuição e captura estrutura que a concatenação perde.
Estágio final (MS-SA / fusão de resultados) treina modelos independentes por ômica e combina as saídas, seja por votação, média ponderada ou meta-aprendizado. É a estratégia mais tolerante a dados faltantes porque um modelo pode ser treinado mesmo sem todas as ômicas para cada amostra.
| Critério | Estágio inicial | Estágio intermediário | Estágio final |
|---|---|---|---|
| Melhor para | Dados pareados, pergunta exploratória | Subtipagem, representação latente | Predição, dados incompletos |
| Ômicas suportadas | Qualquer combinação | Depende do método (MOFA2: flexível) | Qualquer combinação |
| Robustez a missing | Baixa | Média (depende do método) | Alta |
| Escalabilidade | Alta (simples) | Média a alta | Alta |
| Interpretabilidade | Baixa (sem separação por ômica) | Média a alta (fatores latentes) | Média (depende do ensemble) |
| Linguagem | R e Python | R (MOFA2, iClusterPlus, SNFtool) | R e Python |
| Licença | Variada | Código aberto | Variada |
O fluxo de decisão prático segue esta lógica: se os dados são completamente pareados e bem normalizados, a concatenação com PCA ou MOFA2 é um ponto de partida razoável. Se há missingness substancial (acima de 20% das amostras sem uma das ômicas), prefira estágio final. Se a pergunta é subtipagem e você quer interpretabilidade por ômica, SNF ou MOFA2 são escolhas mais defensáveis.
Dica profissional: Ao concatenar ômicas, aplique escalonamento por variância (variance scaling) separadamente em cada bloco antes de unir as matrizes. Sem isso, a ômica com maior número de features domina os primeiros componentes principais e o sinal das demais desaparece.
Métodos de regressão e associação multivariada: CCA, PLS e análise fatorial
Métodos de associação multivariada respondem a uma pergunta específica: quais features de uma ômica se correlacionam com features de outra? Isso os torna ferramentas naturais para descoberta de biomarcadores e para entender como, por exemplo, variantes genéticas influenciam a expressão proteica.
Análise de Correlação Canônica (CCA) encontra combinações lineares de duas matrizes que maximizam a correlação entre elas. É poderosa conceitualmente, mas instável com alta dimensionalidade. A versão regularizada (rCCA) e a sparse CCA resolvem parcialmente esse problema.
Partial Least Squares (PLS) e DIABLO projetam ambas as matrizes em espaços latentes que maximizam a covariância. O pacote mixOmics implementa PLS, sparse PLS, DIABLO e rCCA com uma interface unificada em R, com tutoriais extensos e visualizações de qualidade. É uma das ferramentas mais usadas na literatura de multi-ômicas na pesquisa médica.
Análise fatorial e MOFA2 generalizam a ideia de fatores latentes para múltiplas ômicas simultaneamente. O MOFA2 (Multi-Omics Factor Analysis v2) aprende fatores que explicam variância compartilhada e específica por ômica, com suporte a dados faltantes e a dados single-cell. É implementado em R e Python, com documentação ativa e tutoriais no Bioconductor.
iClusterPlus usa um modelo de mistura latente para integrar múltiplas ômicas e identificar subtipos, com penalização lasso para seleção de features. Disponível no Bioconductor, foi amplamente usado em análises do TCGA.
Pontos de atenção ao aplicar esses métodos:
- Verificar correlações intra-ômica antes: alta colinearidade pode inflar componentes e mascarar sinal real.
- Confirmar que as escalas estão comparáveis após normalização.
- Amostras pequenas (abaixo de 50) tornam estimativas de CCA instáveis; prefira PLS regularizado nesses casos.
- Validar os componentes latentes biologicamente (enriquecimento em vias, sobreposição com QTLs conhecidos) antes de reportar.
Dica profissional: No mixOmics, use a função tune.block.splsda para selecionar o número de componentes e o número de features por ômica via validação cruzada. Pular essa etapa e usar defaults costuma gerar modelos superajustados que não replicam em coortes independentes.
Como métodos de clustering multi-ômico funcionam na prática?
Clustering multi-ômico é a abordagem central para subtipagem molecular não supervisionada. O objetivo é agrupar amostras com base em perfis moleculares similares em múltiplas camadas simultaneamente.
NMF (Non-negative Matrix Factorization) decompõe cada matriz ômica em fatores não negativos, facilitando interpretação biológica porque os fatores correspondem a programas de expressão aditivos. Pacotes como NMF no R e implementações em Python permitem aplicação direta.
Similarity Network Fusion (SNF) constrói uma rede de similaridade entre amostras para cada ômica separadamente e depois funde essas redes iterativamente, amplificando padrões consistentes entre camadas. É especialmente robusto a ruído em ômicas individuais. O pacote SNFtool no R implementa o método completo.
Métodos baseados em kernel mapeiam os dados para espaços de alta dimensão onde estruturas não lineares se tornam separáveis. CIMLR (Cancer Integration via Multikernel Learning) aprende kernels ótimos para cada ômica e os combina, com implementação em R e MATLAB.
NEMO (Neighborhood based Multi-Omics clustering) é uma alternativa mais recente que não requer dados completos para todas as amostras, tornando-o útil quando há missingness por ômica.
Workflow típico de subtipagem multi-ômica:
- Pré-processar cada ômica separadamente (normalização, remoção de features de baixa variância, correção de batch).
- Construir matrizes de similaridade entre amostras para cada ômica (distância euclidiana, correlação de Pearson ou kernel gaussiano).
- Fundir as redes de similaridade (SNF) ou aprender fatores latentes conjuntos (NMF, MOFA2).
- Aplicar clustering espectral ou detecção de comunidades na rede fundida.
- Avaliar estabilidade dos clusters por reamostramento (bootstrap, jackknife) e calcular silhouette score.
- Validar biologicamente: enriquecimento em vias por cluster, associação com desfecho clínico, diferenças em covariáveis independentes.
Para avaliar o número ideal de clusters, o mapa de consenso (consensus clustering, pacote ConsensusClusterPlus no R) é a abordagem mais usada na literatura. Ele reamostra os dados repetidamente e mede a estabilidade de cada solução de clustering.
Por que abordagens baseadas em redes capturam o que outros métodos perdem?
Redes moleculares representam interações entre genes, proteínas e metabólitos de forma que matrizes de features não conseguem. Dois genes podem ter expressão similar em todos os pacientes, mas só revelar seu papel biológico quando analisados em conjunto com seus parceiros de interação. Essa é a premissa central dos métodos baseados em redes para integração multi-ômica.
As principais famílias de métodos de rede aplicados à integração ômica são:
- Inferência de rede de coexpressão: WGCNA identifica módulos de genes co-expressos; ARACNe infere redes de regulação transcricional a partir de informação mútua. Ambos podem ser aplicados por ômica e depois integrados por sobreposição de módulos.
- Propagação e difusão em rede: algoritmos como random walk with restart (RWR) propagam sinais de genes-semente (por exemplo, genes mutados) por uma rede de interação proteína-proteína, priorizando genes funcionalmente próximos mesmo que não apareçam diretamente nos dados ômicos.
- Agregação de módulos entre ômicas: ferramentas como MUUMI implementam SNF e NMF para agregar comunidades de rede entre ômicas, com meta-análise estatística integrada que melhora a robustez das assinaturas identificadas.
Um exemplo concreto de interpretação: em um estudo de doença rara, a propagação em rede a partir de variantes raras identificadas por sequenciamento de exoma pode priorizar proteínas funcionalmente conectadas que aparecem desreguladas na proteômica. Esse subgrafo de proteínas co-reguladas e funcionalmente conectadas é um candidato a alvo terapêutico muito mais defensável do que uma lista de hits individuais sem contexto de rede.
Dica profissional: Incorpore bases de conhecimento como STRING (interações proteína-proteína), KEGG e Reactome como prior para construção ou filtragem de redes. Redes puramente derivadas dos dados têm alta taxa de falsos positivos em amostras pequenas; o prior biológico funciona como regularização e melhora a interpretabilidade dos módulos identificados.
Quando vale usar modelos de deep learning em análises multi-ômicas?
Modelos profundos e generativos abriram novas possibilidades para integração multi-ômica, especialmente em imputação de dados faltantes, correção de batch e aprendizado de representações latentes compartilhadas entre ômicas. Mas eles não são a escolha padrão para a maioria dos projetos.
Autoencoders variacionais (VAEs) aprendem uma distribuição latente dos dados e podem gerar amostras sintéticas, imputar valores faltantes e harmonizar dados de diferentes plataformas. Variantes com disentanglement separam fatores de variação biológica de fatores técnicos (batch). Variantes adversariais (como os usados em scVI e totalVI para single-cell) adicionam um discriminador para forçar a remoção de efeitos de batch.
Contrastive learning treina representações que aproximam amostras biologicamente similares e afastam amostras dissimilares, sem necessidade de rótulos explícitos. Aplicações em multi-ômica incluem alinhamento de modalidades (por exemplo, alinhar scRNA-seq e scATAC-seq da mesma célula).
Modelos multimodais como CLIP adaptados para dados ômicos aprendem embeddings conjuntos de múltiplas modalidades, permitindo transferência de informação entre ômicas mesmo quando não há amostras completamente pareadas.
Segundo revisão técnica sobre modelos generativos em multi-ômicas, esses métodos exigem grandes volumes de dados para generalizar bem e são propensos a overfitting em coortes pequenas. A validação experimental dos padrões aprendidos é indispensável.
Pontos práticos:
- Use VAEs quando tiver pelo menos algumas centenas de amostras e dados com missingness substancial que métodos clássicos de imputação não resolvem bem.
- Para single-cell multi-ômico, scVI, totalVI e Seurat v5 (com WNN) são implementações maduras em Python e R com comunidade ativa.
- Para dados bulk com amostras limitadas, métodos clássicos (MOFA2, SNF, mixOmics) costumam ser mais estáveis e interpretáveis.
- Frameworks recomendados: PyTorch e TensorFlow para implementações customizadas; JAX para pesquisa de fronteira.
Dica profissional: Antes de treinar um VAE em dados multi-ômicos, verifique se a variância explicada pelos primeiros componentes de PCA por ômica é razoável. Se uma ômica tem estrutura muito fraca (PCA plano, sem separação biológica), um modelo generativo vai aprender ruído. Corrija o problema na ômica antes de integrá-la.
Pré-processamento: o que fazer antes de integrar os dados?
Pré-processamento inadequado é a causa mais frequente de falhas em projetos de integração multi-ômica. A diferença entre plataformas (RNA-seq vs microarray, por exemplo) pode invalidar integrações inteiras sem harmonização adequada, conforme análise metodológica sobre correção de batch e agregação de módulos.
Checklist passo a passo:
- Controle de qualidade por ômica: remover amostras com cobertura insuficiente (RNA-seq), baixa correlação com réplicas técnicas (proteômica) ou valores de metilação fora do intervalo esperado. Ferramentas: FastQC, MultiQC, plotQC (Seurat).
- Normalização específica por plataforma: TMM ou DESeq2 para RNA-seq; quantile normalization para microarray; loess para proteômica por espectrometria de massas; beta-mixture quantile normalization (BMIQ) para arrays de metilação.
- Transformação: log2 ou variance stabilizing transformation (VST) para dados de contagem; transformação M-value para metilação quando usar métodos lineares.
- Detecção e correção de batch: ComBat (sva package, R) para efeitos de batch conhecidos; Harmony para single-cell; PEER para fatores de confusão latentes em transcriptômica. Sempre verificar se a correção removeu o efeito técnico sem remover sinal biológico (PCA antes e depois).
- Imputação de valores faltantes: kNN imputation para dados com missingness aleatório; missForest para padrões mais complexos; para proteômica, imputação por distribuição truncada (MNAR) é mais adequada.
- Seleção de features: remover features de variância próxima de zero antes da integração; aplicar seleção supervisionada (limma, DESeq2) apenas se houver rótulos e validação cruzada rigorosa.
Problemas comuns e como mitigá-los:
- Ômica dominante na concatenação: aplicar variance scaling por bloco antes de unir.
- IDs de amostras inconsistentes entre ômicas: padronizar nomenclatura antes de qualquer análise (um erro de ID quebra o pareamento silenciosamente).
- Covariáveis clínicas desbalanceadas entre batches: verificar distribuição de idade, sexo e estágio por batch antes de corrigir.
Dica profissional: Invista pelo menos tanto tempo na harmonização de metadados quanto na escolha do algoritmo de integração. Um modelo sofisticado aplicado a dados com IDs de amostras trocados ou batches não corrigidos produz resultados biologicamente incoerentes que passam despercebidos até a etapa de validação.
Como avaliar se uma integração multi-ômica funcionou?
Avaliar integração multi-ômica exige combinar métricas técnicas com critérios biológicos. Uma solução tecnicamente elegante que não replica em coorte independente ou não tem suporte funcional não tem valor translacional.
Métricas técnicas:
- Estabilidade de clusters: consensus clustering com reamostramento; proporção de amostras consistentemente co-clusterizadas (cophenetic correlation coefficient).
- Silhouette score: mede coesão e separação dos clusters; valores acima de 0,25 indicam estrutura razoável.
- ARI (Adjusted Rand Index): compara partições entre diferentes rodadas ou métodos; útil para avaliar reprodutibilidade.
- AUC: para tarefas supervisionadas (predição de desfecho), AUC em conjunto de teste independente é a métrica central.
- Preservação de estrutura de grafo: para métodos baseados em rede, métricas como modulePreservation (WGCNA) avaliam se módulos identificados em uma coorte se preservam em outra.
Critérios biológicos:
- Enriquecimento em vias (GSEA, ORA com bases como Reactome, KEGG, MSigDB) nos genes/proteínas que definem cada cluster ou fator latente.
- Co-localização com QTLs conhecidos (eQTLs do GTEx, pQTLs) para validar que os fatores capturados têm base genética.
- Validação experimental: ensaios funcionais em modelos celulares (iPSC, organoides), triagem de compostos, knockdown/knockout de candidatos.
Boas práticas para benchmarking:
- Usar conjuntos de dados públicos com ground truth conhecido (subtipos de câncer do TCGA com validação clínica publicada) para comparar métodos antes de aplicar em dados próprios.
- Validação cruzada estratificada por batch, não apenas por amostra, para evitar vazamento de informação técnica.
- Replicar em coorte independente antes de qualquer conclusão biológica.
Dica profissional: Documente e compartilhe pipelines em containers (Docker, Singularity) ou notebooks reprodutíveis (Quarto, Jupyter). Análises de integração multi-ômica têm muitos parâmetros; sem reprodutibilidade explícita, é impossível distinguir um resultado biológico real de um artefato de configuração. Os materiais de treinamento do EBI incluem exemplos de notebooks reprodutíveis que servem como modelo.
Quais ferramentas usar e como acessá-las no Brasil?
As ferramentas abaixo cobrem os principais objetivos de integração multi-ômica e estão disponíveis como código aberto, com comunidades ativas e tutoriais acessíveis.
Dicas para pesquisadores no Brasil:
- O Bioconductor centraliza MOFA2, iClusterPlus, MultiAssayExperiment e SNFtool; a instalação é direta via
BiocManager::install(). - A RNP (Rede Nacional de Ensino e Pesquisa) oferece infraestrutura de computação em nuvem para grupos acadêmicos brasileiros, com acesso via credenciais institucionais. Para análises de grande escala (single-cell com milhões de células, por exemplo), isso evita custos de cloud comercial.
- Centros de computação de alto desempenho como o LNCC (Laboratório Nacional de Computação Científica) e o CENAPAD têm programas de acesso para projetos de pesquisa.
- Os materiais de treinamento do EBI estão em inglês, mas são os mais completos disponíveis gratuitamente; grupos brasileiros têm traduzido e adaptado partes desses materiais em disciplinas de pós-graduação.
- O MultiAssayExperiment (Bioconductor) é o container padrão para armazenar e manipular dados multi-ômicos em R, com suporte a metadados de amostras e integração direta com pacotes de análise.
Estudo de caso: integração multi-ômica em doenças raras
Doenças genéticas raras apresentam um desafio único para a integração multi-ômica: coortes pequenas (às vezes um único paciente), ausência de dados públicos comparáveis e necessidade de tradução rápida para decisões terapêuticas. Esse contexto exige uma abordagem diferente da subtipagem de câncer em larga escala.
Cenário típico: um paciente com doença genética ultrarara sem diagnóstico molecular confirmado ou sem tratamento aprovado. A pergunta científica é dupla: qual é o mecanismo molecular da doença neste paciente específico, e quais compostos têm maior probabilidade de reverter o fenótipo celular?
Workflow descritivo:
Células do paciente (fibroblastos ou sangue)
        ↓
Reprogramação para iPSC (validação: pluripotência, cariotipagem)
        ↓
Diferenciação para tipo celular relevante (neurônios, hepatócitos, cardiomiócitos)
        ↓
Geração de dados multi-ômicos:
  • Transcriptômica (RNA-seq bulk ou single-cell)
  • Proteômica (LC-MS/MS)
  • Metabolômica (LC-MS)
        ↓
Pré-processamento e integração (MOFA2 ou SNF para fatores latentes)
        ↓
Identificação de vias desreguladas e candidatos a alvo
        ↓
Triagem paralela de compostos (FDA-approved library, ASOs customizados)
        ↓
Validação funcional (ensaios de viabilidade, função celular, biomarcadores)
A integração das três camadas ômicas nesse contexto serve para priorizar: genes e proteínas que aparecem desregulados em múltiplas camadas simultaneamente são candidatos a alvo mais robustos do que hits em uma única ômica. A metabolômica adiciona informação sobre o estado funcional da célula que a transcriptômica não captura diretamente.
A Hopeatrarelabs aplica exatamente essa lógica em seus programas de modelagem personalizada, combinando iPSC, edição por CRISPR e triagem paralela de compostos com interpretação multi-ômica para identificar biomarcadores e candidatos terapêuticos em doenças sem tratamento aprovado.
Dica profissional: Ao planejar uma parceria com laboratório especializado para análise multi-ômica em doença rara, entregue no mínimo: sequenciamento de exoma ou genoma do paciente (VCF anotado), relatório clínico detalhado com fenótipo, e amostras celulares com passagem documentada. Formatos padronizados e metadados completos reduzem o tempo de onboarding e aumentam a qualidade da integração.
Roteiro prático para escolher e iniciar uma integração multi-ômica
Antes de escolher um algoritmo, é preciso responder perguntas mais básicas sobre os dados e o objetivo. Este roteiro organiza as decisões na ordem em que elas realmente importam.
-
Definir a pergunta biológica com precisão. "Entender a doença" não é uma pergunta. "Identificar subtipos moleculares de pacientes com doença X que predizem resposta ao tratamento Y" é. A pergunta determina se o problema é supervisionado ou não supervisionado, e qual métrica de sucesso usar.
-
Inventariar os dados disponíveis. Listar cada ômica disponível, número de amostras por ômica, proporção de amostras completamente pareadas, plataformas usadas e batches de coleta. Uma planilha simples com essa informação evita surpresas no meio da análise.
-
Avaliar qualidade e completude. Calcular proporção de valores faltantes por ômica e por amostra. Se mais de 30% das amostras estão incompletas em alguma ômica, considere se vale incluí-la ou se é melhor começar com as ômicas mais completas.
-
Escolher a estratégia de integração. Dados pareados e completos: estágio inicial ou intermediário. Dados com missingness substancial: estágio final. Pergunta de subtipagem: clustering (SNF, NMF, iClusterPlus). Pergunta de biomarcador: PLS/DIABLO (mixOmics) ou MOFA2. Pergunta de predição: modelos supervisionados com integração intermediária.
-
Planejar o pré-processamento. Para cada ômica, definir método de normalização, estratégia de correção de batch e critério de seleção de features. Documentar cada decisão antes de executar.
-
Executar análise piloto em subconjunto. Antes de rodar o pipeline completo, testar em 20–30% dos dados para verificar se os resultados fazem sentido biologicamente. Isso economiza tempo de computação e identifica problemas de configuração cedo.
-
Planejar a validação. Definir antes da análise quais critérios biológicos e técnicos serão usados para aceitar ou rejeitar os resultados. Validação post-hoc escolhida para confirmar o resultado é uma forma de p-hacking.
Decisões-chave:
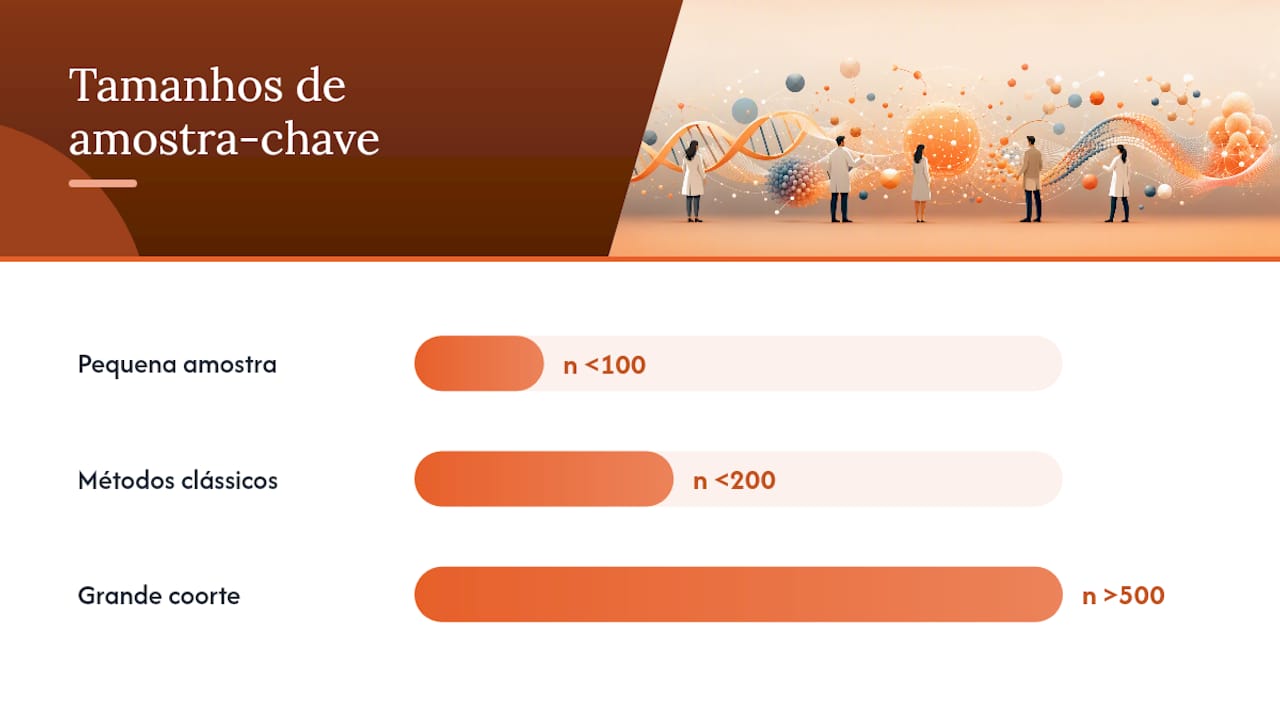
- Deep learning vs métodos clássicos: prefira métodos clássicos (MOFA2, SNF, mixOmics) para amostras abaixo de 200. Deep learning só vale quando há dados suficientes para generalização e quando a pergunta exige imputação ou harmonização em escala.
- Custo computacional: SNF e NMF escalam bem até milhares de amostras em hardware padrão. VAEs e modelos multimodais exigem GPU para treinamento eficiente.
Árvore de decisão simplificada:
- Pequena amostra (n < 100) + dados pareados → MOFA2 ou mixOmics (DIABLO).
- Pequena amostra + dados não pareados → MOFA2 com tratamento de missing ou estágio final.
- Grande coorte (n > 500) + subtipagem → SNF, iClusterPlus ou NMF.
- Grande coorte + predição supervisionada → integração intermediária com validação cruzada estratificada.
Dica profissional: Monte a equipe antes de montar o pipeline. Uma integração multi-ômica bem-sucedida precisa de pelo menos um bioinformata com experiência em cada ômica principal, um estatístico para desenho de validação e um biólogo que possa interpretar os resultados funcionalmente. Equipes só de bioinformatas tendem a otimizar métricas técnicas sem critério biológico; equipes só de biólogos subestimam os riscos de artefatos computacionais.
Perspectiva prática para pesquisadores brasileiros
O Brasil tem uma posição singular no campo da integração multi-ômica: infraestrutura de pesquisa em expansão, grupos de bioinformática competitivos internacionalmente e uma carga de doenças raras que justifica investimento em metodologias de precisão. Ao mesmo tempo, a realidade operacional de muitos laboratórios ainda é de recursos computacionais limitados, financiamento fragmentado e dificuldade de acesso a plataformas de proteômica e metabolômica de alta resolução.
A boa notícia é que os repositórios públicos (TCGA, GEO, GTEx) eliminam a barreira de geração de dados para muitas perguntas de pesquisa. Um grupo com capacidade de análise bioinformática pode publicar trabalhos de alto impacto usando exclusivamente dados públicos, especialmente em subtipagem de câncer e descoberta de biomarcadores. A FAPESP, o CNPq e a CAPES têm financiado projetos de bioinformática e medicina de precisão, e editais específicos para doenças raras têm crescido nos últimos anos, em parte impulsionados pela articulação de associações de pacientes com agências de fomento.
Para parcerias com laboratórios especializados, o modelo mais eficiente é começar com uma análise piloto bem controlada usando dados públicos para validar a abordagem metodológica antes de gerar dados proprietários. Isso reduz o risco financeiro e aumenta a credibilidade do projeto junto a financiadores e parceiros internacionais. Colaborações com grupos do INCA, do Hospital das Clínicas e de universidades federais com programas de genômica (USP, UNICAMP, UFRGS) oferecem acesso a coortes clínicas que raramente aparecem em repositórios públicos.
Dica profissional: Com recursos limitados, comece com uma ômica bem controlada e adicione camadas progressivamente. Uma transcriptômica de alta qualidade com metadados clínicos completos gera mais impacto do que três ômicas mal normalizadas integradas de qualquer forma.
A Hopeatrarelabs oferece programas especializados para doenças raras
Para pesquisadores e equipes clínicas que trabalham com doenças genéticas raras, a distância entre gerar dados multi-ômicos e extrair conclusões terapêuticas acionáveis é onde a maioria dos projetos trava. A Hopeatrarelabs resolve exatamente esse gargalo: em vez de entregar apenas dados brutos ou análises genéricas, a empresa desenvolve modelos de doença personalizados a partir das células do próprio paciente, usando iPSC e edição por CRISPR, e integra transcriptômica, proteômica e metabolômica para identificar candidatos terapêuticos com suporte funcional.
O diferencial concreto é a triagem paralela de milhares de compostos aprovados pela FDA, programas customizados de ASOs e avaliação de terapias gênicas, tudo dentro de um único programa científico com transparência de resultados. Para fundações, médicos e parceiros biofarmacêuticos que precisam de respostas rápidas para doenças sem tratamento, esse modelo integrado reduz o tempo entre hipótese e evidência funcional. Acesse os recursos e programas da Hopeatrarelabs para entender como iniciar uma colaboração ou solicite uma consulta diretamente em Hopeatrarelabs.
Fontes
- A technical review of multi-omics data integration methods
- Unsupervised Multi-Omics Data Integration Methods: A Comprehensive Review - PMC
- A technical review of multi-omics data integration methods: from classical statistical to deep generative approaches
- Computational approaches for network-based integrative multi-omics analysis
- Comparação de estratégias computacionais para integração de dados ômicos na classificação de subtipos de tumores
- MUUMI: an R package for statistical and network-based meta-analysis for multi-omics data integration | BMC Bioinformatics | Springer Nature Link
- Introduction to multi-omics data integration and visualisation
- Cancergenome
Este artigo fornece informações gerais e não substitui a orientação de um médico qualificado. Consulte um profissional de saúde qualificado sobre o seu caso antes de agir com base neste conteúdo.